NVIDIA, 해석 엔지니어를 위한 CUDA 코어 5만 개 이상 GPU 준비
NVIDIA가 Rubin HPC를 발표했다. 이는 Vera Rubin 플랫폼 안의 별도 그래픽 프로세서로, 회사는 이를 시뮬레이션, 엔지니어링 해석, 데이터 분석, AI를 위해 만들고 있다. 이 칩에는 5만 개가 넘는 CUDA 코어가 들어간다. NVIDIA에 따르면 단일 GPU로는 기록적인 수치이며 Hopper의 약 3배다. 출시는 2028년으로 예상된다.
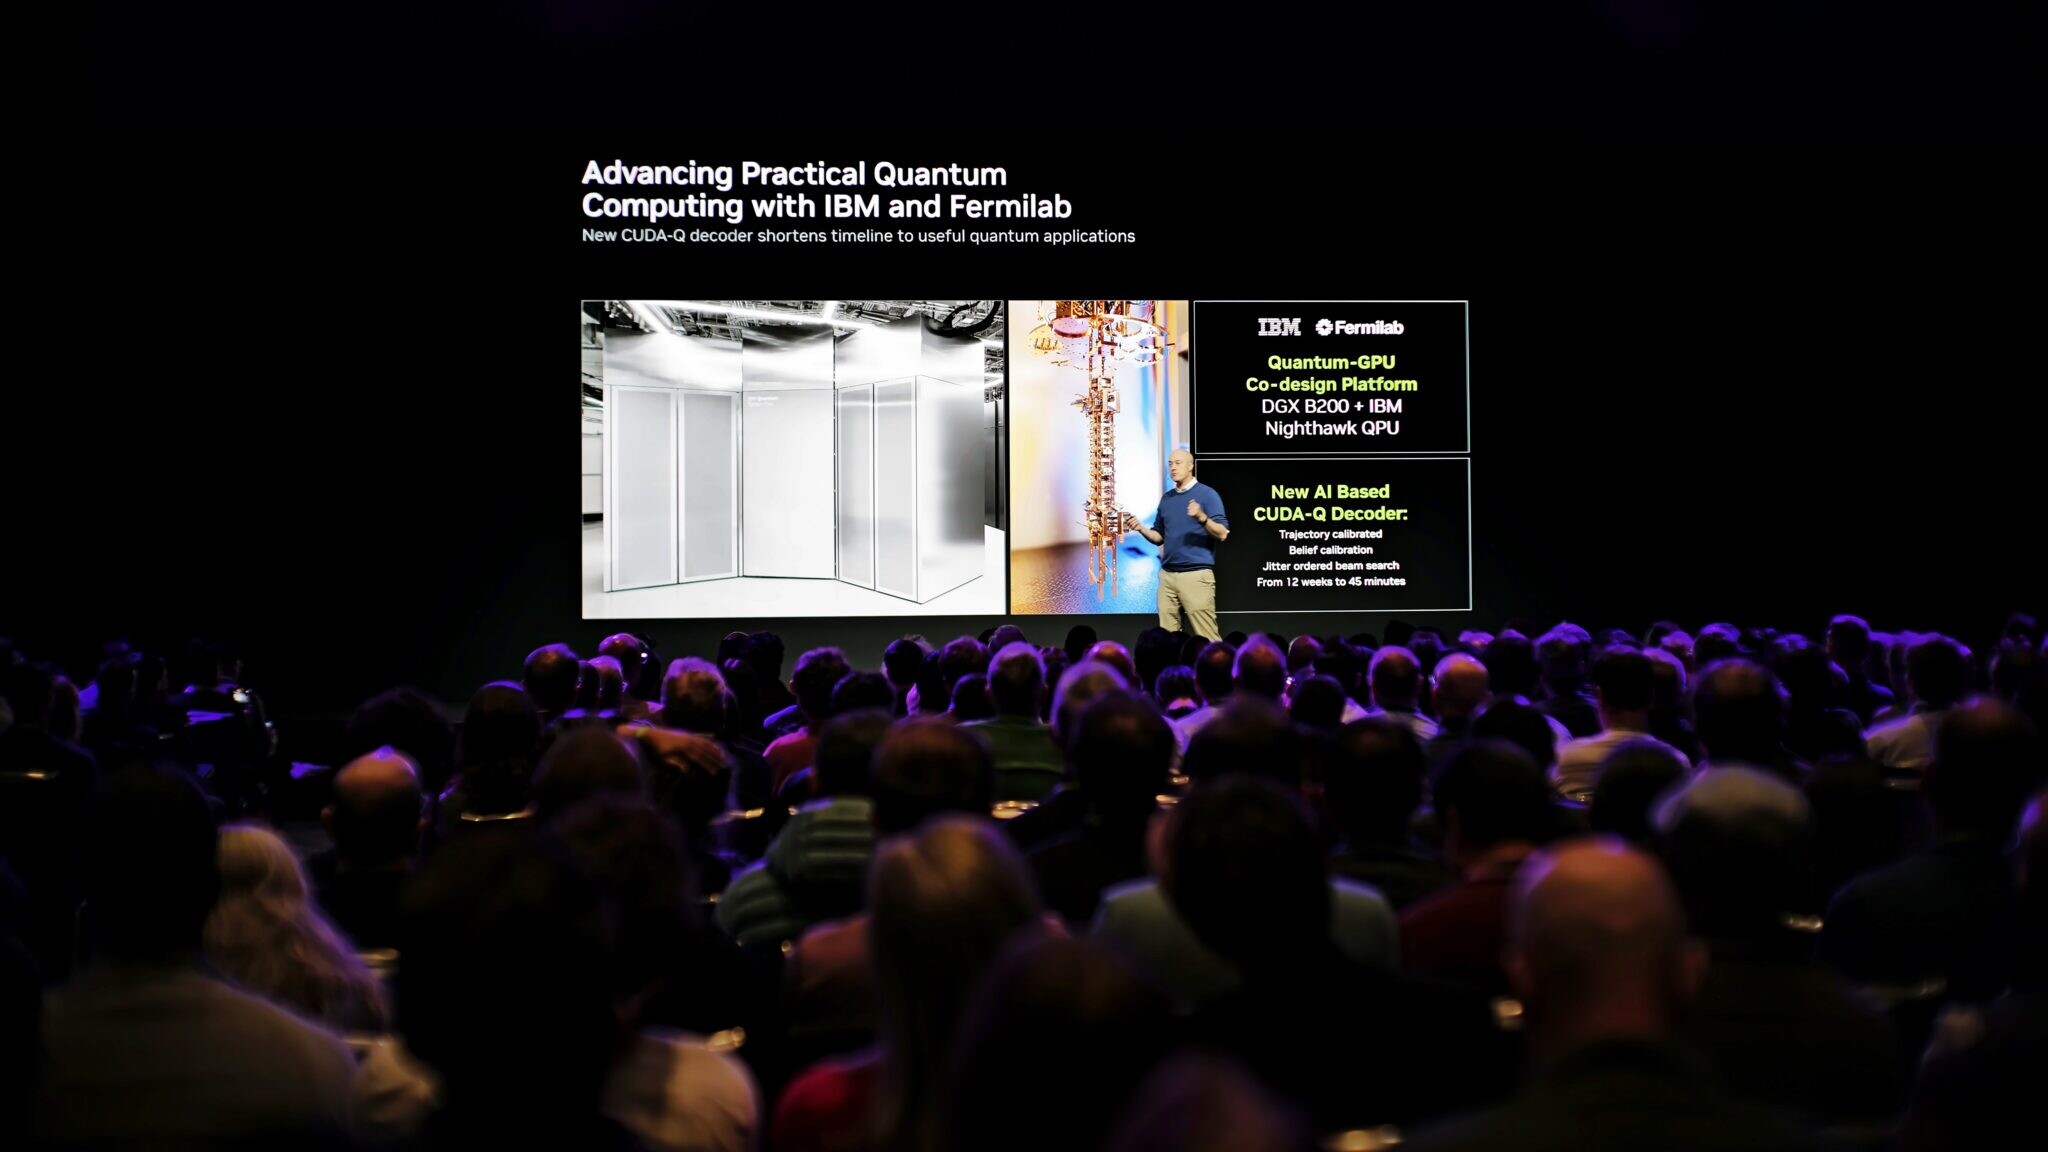
발표는 2026년 11월 16일 시카고에서 열린 SC26 콘퍼런스에서 이뤄졌다. 신제품은 NVIDIA의 하이퍼스케일·고성능 컴퓨팅 담당 부사장 Ian Buck이 소개했다. CFD, 유한요소, 충돌 시뮬레이션을 다루는 이들에게 이는 뚜렷한 신호다. 회사가 Vera Rubin 플랫폼 안에 과학·엔지니어링 해석을 지향하는 별도 GPU를 배정하고 있기 때문이다.
칩에 대해 알려진 것
NVIDIA가 지금까지 공개한 기술 자료는 많지 않다. 확인된 내용은 다음과 같다.
- 단일 GPU에 5만 개가 넘는 CUDA 코어, Hopper의 약 3배;
- 배정도 FP64부터 4비트 FP4까지의 정밀도 범위 지원;
- 희소 데이터 처리 가속;
- 7세대 NVLink를 통한 GPU 간 연결.
해석 엔지니어에게 여기서 핵심은 FP64 항목이다. 배정도는 반올림 오차가 단계마다 누적되는 과제에서 필요하다. 긴 비정상 CFD 계산, 유한요소법의 강성 방정식계, 기후 모델링 등이 그렇다. 희소 데이터 가속도 같은 영역에 속한다. 강성 행렬과 유체역학용 격자는 거의 전부가 0으로 이뤄져 있고, 회사 설명에 따르면 이 기능은 코어가 데이터를 기다리며 유휴 상태에 놓이지 않게 하는 데 필요하다. 7세대 NVLink는 GPU 간 교환을 담당하는데, 하나의 큰 격자가 여러 가속기에 분산된 경우 중요하다.
발표에는 실무적인 질문에 대한 답이 없다. NVIDIA는 FP64의 실제 성능을 밝히지 않았고, 그것이 칩 자체의 블록으로 제공되는지 텐서 코어 에뮬레이션으로 제공되는지도 명확히 하지 않았다. 일반 Rubin과의 비교도 없다. 메모리 용량과 종류, 소비 전력, Rubin HPC가 들어갈 시스템 구성도 아직 공개되지 않았다. 워크스테이션과 클라우드 인스턴스에 대한 언급도 없었다.
NVIDIA가 시뮬레이션을 에이전트와 연결하는 이유
회사는 Rubin HPC의 등장을 AI 에이전트로 설명한다. 에이전트는 소재, 분자, 설계의 여러 변형을 훑어보고 각 변형은 시뮬레이션으로 검증해야 하므로 계산량이 늘어난다. Buck은 미래의 '과학 스택'을 이렇게 설명했다.
«컴퓨팅의 최전선과 새로운 과학 스택은 언제나 그랬듯 시뮬레이션이 될 것이다. 다만 AI와 미래의 양자 컴퓨팅과 결합된 형태로».
SC26에서 Buck은 그런 에이전트가 실제로 작동하는 사례를 들었다. 스웨덴 왕립공과대학 KTH의 에이전트는 망가진 GROMACS 설정을 스스로 고친다. 단 하나의 DGX Spark에서 하룻밤 동안 테스트 케이스의 81%를 수정했다. NVIDIA 자체 에이전트인 Nsight AI Porting Agent는 기상 모델 WRF의 한 루틴을 GPU로 이식해 5배 이상 가속했다. 여기에는 약 1억 5000만 토큰이 쓰였다. 해석 코드를 그래픽카드로 이식해 본 이들에게 이는 그런 작업의 일부를 모델이 맡을 수 있음을 보여주는 예다. 회사는 GPU와 함께 Nemotron for Science도 공개했다. 화학 데이터세트를 갖춘 오픈 모델로, DGX Spark에서 자체 슈퍼컴퓨터까지 로컬에서 구동할 수 있다.
NVIDIA, OpenFOAM 등 패키지에서 Vera 프로세서 측정치 제시
이와 함께 NVIDIA는 Vera 프로세서 기반 플랫폼을 확장했다. Buck은 에이전트가 모델 단계 사이에 도구 호출을 수행하려면 CPU가 필요하다고 설명했다. 독일 기후컴퓨팅센터 DKRZ는 슈퍼컴퓨터 HLRE-5용으로 Vera를 선택했으며, 가동은 2028년 초로 예상된다. 그 전에는 텍사스 고등컴퓨팅센터 TACC가 Vera 기반 시스템을 발표했다.
테스트 결과는 회사가 별도 문서 NVIDIA Vera CPU HPC Performance Brief로 공개했다. 여기에는 엔지니어에게 익숙한 과제들의 측정치가 모여 있다. Stream 테스트의 메모리 대역폭, 기상 모델 WRF, OpenFOAM의 유체역학, OpenRadioss의 충돌 시뮬레이션, 희소 선형대수 HPCG, 유전체학 등이다. 로스앨러모스 연구소와 TACC의 사례 분석, 액체 냉각 랙 설명도 함께 담겼다. 문서의 표현 예시는 이렇다. 「Vera는 OpenFOAM 모델에서 와트당 2.4배 높은 성능을 제공한다」. 다른 수치로는 와트당 메모리 대역폭 3.4배 이상, WRF에서 와트당 성능 2배, HPCG에서 성능과 와트당 성능 모두 2배 이상이 있다. x86 기반 기준 시스템과 비교한 TACC의 테스트에서 Vera는 MuST에서 2.2배, PSDNS에서 5.5배, MILC에서 7.5배 빨랐다. 이 모든 데이터는 NVIDIA가 직접 공개한 것이다.
엔지니어와 스튜디오에게 갖는 의미
Rubin HPC 출시까지는 1년 이상 남았고, 지금까지는 핵심 수치 없는 선언에 그친다. 설명을 보면 NVIDIA는 과학 해석을 AI 가속기에 전부 맡기지 않고 플랫폼 안의 별도 방향으로 분리하고 있다. AI 가속기에서는 배정도가 통상 우선순위가 아니다. 해석 엔지니어와 설계 엔지니어에게는 자신들의 과제에 더 맞는 가속기가 생길 수 있다. 다만 이를 두고 구매나 클라우드 전환을 계획해야 할지 판단하기는 이르다. 배정도 성능도, 메모리도, 가격도, 통합 파트너도 아직 밝혀지지 않았다.
아티스트, VFX 스튜디오, 게임 개발자에게 이 발표가 직접 바꾸는 것은 없다. 간접적인 이점은 칩의 새 기능을 활용하게 될 시뮬레이션 패키지를 통해 나타날 수 있다. DKRZ와 TACC의 Vera 프로세서처럼, 신제품을 먼저 시험하는 쪽은 대형 컴퓨팅 센터일 것이다. CAE 소프트웨어, 특히 CFD와 유한요소법 솔버 공급사는 희소 데이터 가속에 맞춰 코드를 손봐야 할 가능성이 크고, 일반 엔지니어링 부서가 효과를 체감하는 시점은 그 작업 속도에 달려 있다.
Rubin HPC에 대해 NVIDIA로부터 가장 먼저 듣고 싶은 수치는 무엇인가.
- FP64 성능
- 메모리 용량