NVIDIA bereitet für Simulationsspezialisten eine GPU mit über 50.000 CUDA-Kernen vor
NVIDIA hat Rubin HPC angekündigt. Es handelt sich um einen eigenständigen Grafikprozessor innerhalb der Plattform Vera Rubin, den das Unternehmen für Simulationen, Ingenieurberechnungen, Datenanalyse und KI entwickelt. Der Chip verfügt über mehr als 50.000 CUDA-Kerne. Nach Angaben von NVIDIA ist das ein Rekord für eine einzelne GPU und etwa dreimal so viel wie bei Hopper. Der Start wird für 2028 erwartet.
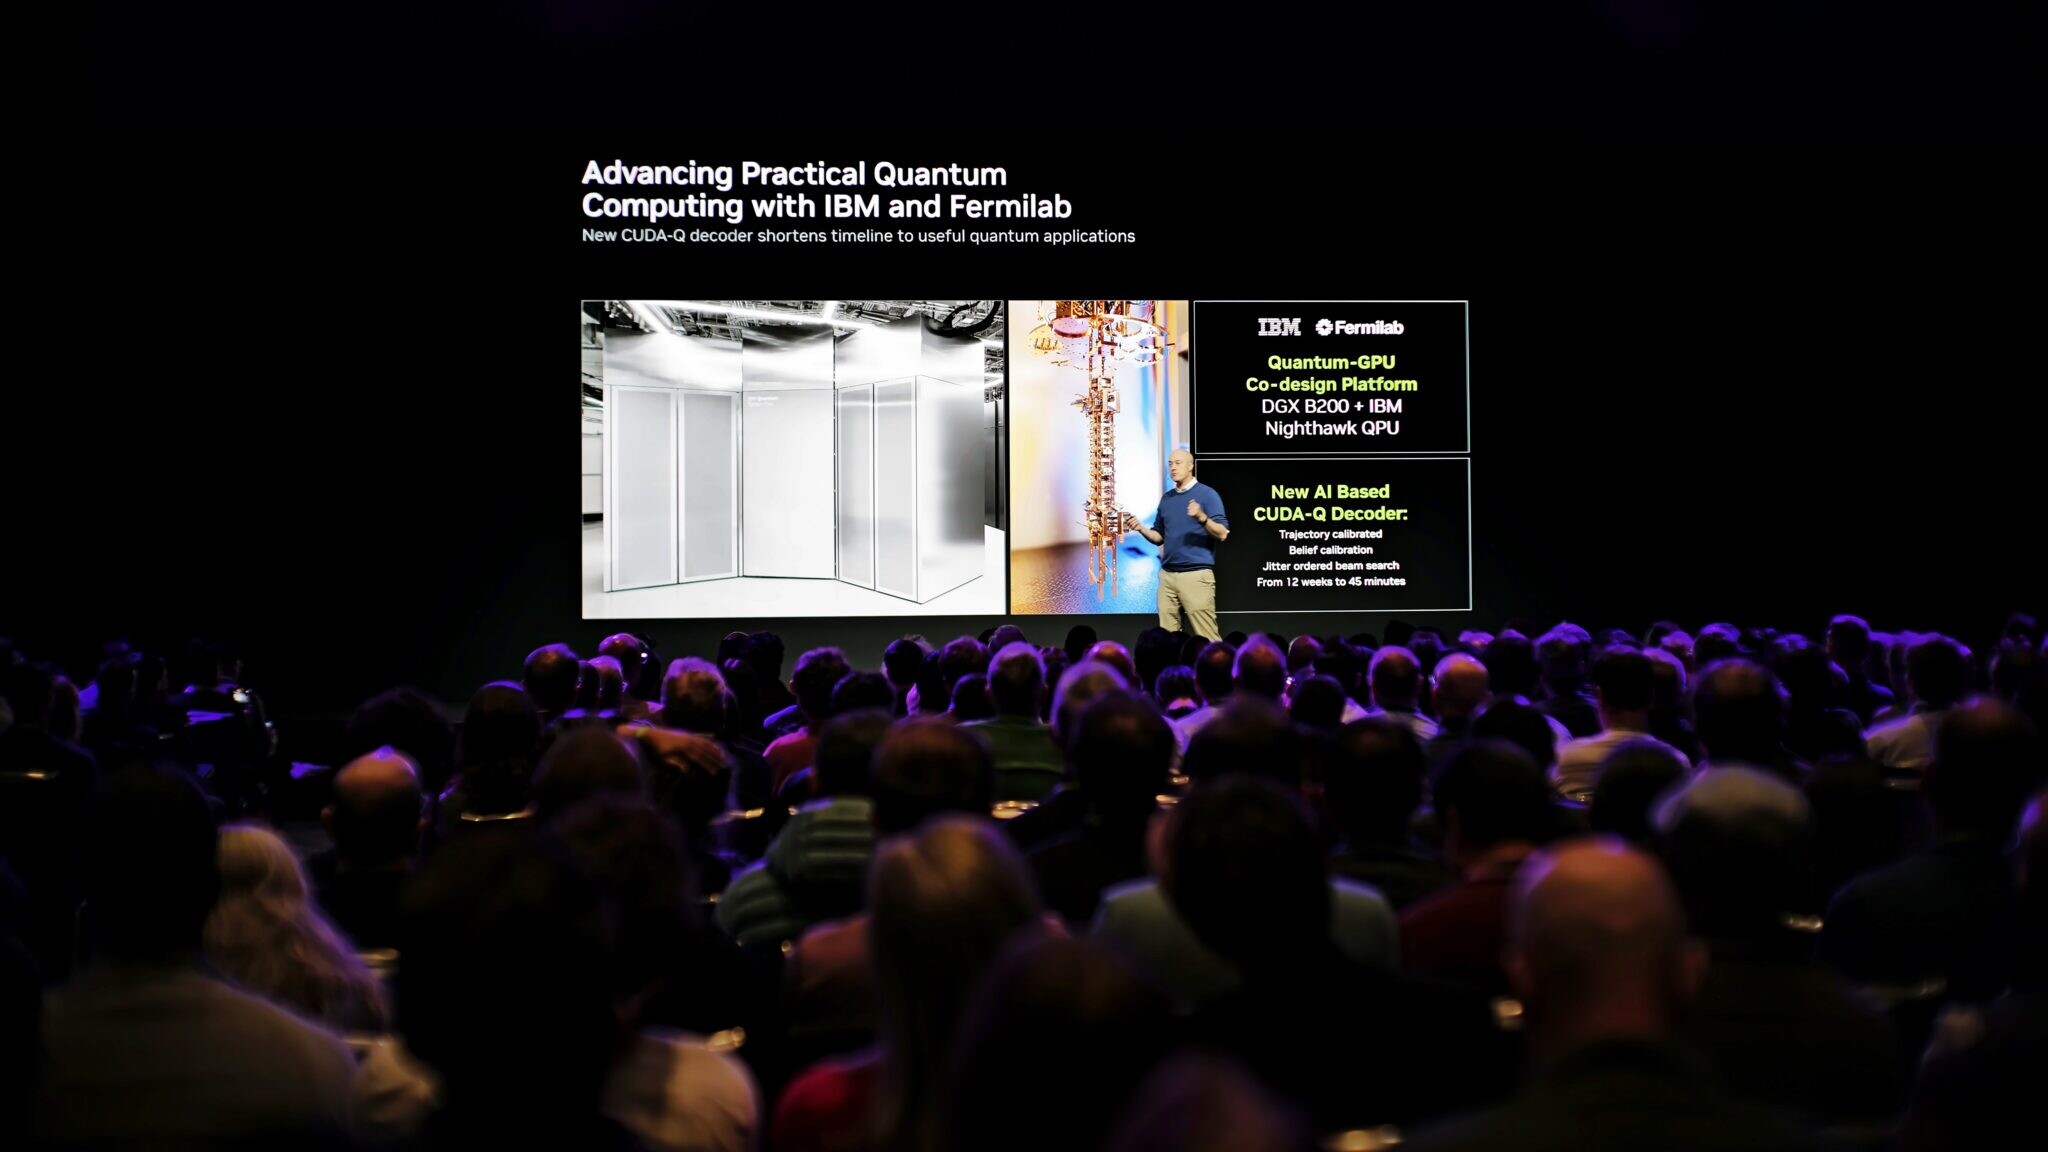
Die Ankündigung erfolgte am 16. November 2026 auf der Konferenz SC26 in Chicago. Vorgestellt wurde die Neuheit von Ian Buck, Vice President für Hyperscale- und High-Performance-Computing bei NVIDIA. Für alle, die mit CFD, Finiten Elementen und Crash-Simulationen arbeiten, ist das ein deutliches Signal: Das Unternehmen stellt innerhalb der Plattform Vera Rubin eine eigene GPU bereit, die auf wissenschaftliche und technische Berechnungen ausgerichtet ist.
Was über den Chip bekannt ist
Technische Daten hat NVIDIA bislang nur wenige veröffentlicht. Bestätigt ist Folgendes:
- mehr als 50.000 CUDA-Kerne auf einer GPU, etwa dreimal so viele wie bei Hopper;
- Unterstützung eines Genauigkeitsspektrums von doppelter Genauigkeit FP64 bis zu vierbittigem FP4;
- Beschleunigung der Arbeit mit spärlich besetzten Daten;
- Verbindung zwischen GPUs über NVLink der siebten Generation.
Für Simulationsspezialisten ist die Zeile zu FP64 hier die wichtigste. Doppelte Genauigkeit wird bei Aufgaben benötigt, in denen sich Rundungsfehler Schritt für Schritt aufsummieren: bei langen transienten CFD-Durchläufen, bei steifen Gleichungssystemen in der FEM, bei der Klimamodellierung. Die Beschleunigung spärlich besetzter Daten gehört in denselben Bereich. Steifigkeitsmatrizen und Netze für die Strömungsmechanik bestehen fast vollständig aus Nullen, und wie das Unternehmen erläutert, soll diese Fähigkeit verhindern, dass die Kerne im Wartezustand auf Daten leerlaufen. NVLink der siebten Generation ist für den Austausch zwischen GPUs verantwortlich, was wichtig ist, wenn ein großes Netz über mehrere Beschleuniger verteilt ist.
Antworten auf praktische Fragen enthält die Ankündigung nicht. NVIDIA hat weder die reale FP64-Leistung genannt noch präzisiert, ob diese durch eigene Blöcke des Chips oder durch Emulation auf Tensor-Kernen erbracht wird. Ein Vergleich mit dem normalen Rubin fehlt ebenfalls. Umfang und Typ des Speichers, der Energiebedarf und die Zusammensetzung der Systeme, in die Rubin HPC einfließen wird, sind bislang nicht offengelegt. Von Workstations und Cloud-Instanzen war nicht die Rede.
Warum NVIDIA Simulation mit Agenten verknüpft
Das Unternehmen erklärt das Erscheinen von Rubin HPC über KI-Agenten. Agenten testen Varianten von Materialien, Molekülen und Konstruktionen durch, und jede Variante muss per Simulation geprüft werden, weshalb die Zahl der Berechnungen zunimmt. Buck beschrieb den künftigen „Wissenschafts-Stack“ so:
«Die Spitze des Rechnens und der neue Wissenschafts-Stack wird die Simulation sein, wie immer schon, aber in Kombination mit KI und künftigem Quantencomputing».
Auf der SC26 führte Buck Beispiele für solche Agenten im Einsatz an. Ein Agent des schwedischen Königlichen Instituts für Technologie KTH reparierte selbstständig fehlerhafte GROMACS-Konfigurationen. In einer einzigen Nacht auf einem einzelnen DGX Spark korrigierte er 81 % der Testfälle. Der eigene Agent von NVIDIA, der Nsight AI Porting Agent, portierte eine Routine aus dem Wettermodell WRF auf die GPU und beschleunigte sie um mehr als das Fünffache. Dafür wurden etwa 150 Mio. Token benötigt. Für alle, die Rechencode auf Grafikkarten portiert haben, ist das ein Beispiel dafür, wie ein Modell einen Teil dieser Arbeit übernehmen kann. Zusammen mit der GPU stellte das Unternehmen Nemotron for Science vor. Das ist ein offenes Modell mit einem Datensatz zur Chemie, das lokal betrieben werden kann, vom DGX Spark bis zum eigenen Supercomputer.
NVIDIA legt Messwerte des Vera-Prozessors in OpenFOAM und weiteren Paketen vor
Parallel dazu hat NVIDIA die Plattform auf Basis des Vera-Prozessors erweitert. Buck erläuterte, dass Agenten eine CPU benötigen, um zwischen den Modellschritten Tool-Aufrufe auszuführen. Das Deutsche Klimarechenzentrum DKRZ hat Vera für den Supercomputer HLRE-5 ausgewählt, dessen Inbetriebnahme für Anfang 2028 erwartet wird. Zuvor hatte das Texas Advanced Computing Center TACC Systeme auf Vera-Basis angekündigt.
Die Testergebnisse hat das Unternehmen in einem separaten Dokument veröffentlicht, dem NVIDIA Vera CPU HPC Performance Brief. Darin sind Messungen zu Aufgaben zusammengestellt, die Ingenieuren vertraut sind: Speicherbandbreite im Stream-Test, das Wettermodell WRF, Strömungsmechanik in OpenFOAM, Crash-Simulation in OpenRadioss, spärlich besetzte lineare Algebra HPCG und Genomik. Ebenfalls enthalten sind Fallanalysen aus dem Los Alamos National Laboratory und von TACC sowie eine Beschreibung der Racks mit Flüssigkeitskühlung. Ein Formulierungsbeispiel aus dem Dokument: „Vera liefert eine 2,4-mal höhere Leistung pro Watt im OpenFOAM-Modell“. Unter den weiteren Zahlen: mehr als 3,4-mal höhere Speicherbandbreite pro Watt, doppelt so hohe Leistung pro Watt in WRF, mehr als doppelt so hohe Leistung und Leistung pro Watt in HPCG. In den Tests von TACC gegen ein Basissystem auf x86-Basis war Vera 2,2-mal schneller bei MuST, 5,5-mal schneller bei PSDNS und 7,5-mal schneller bei MILC. Alle diese Daten wurden von NVIDIA selbst veröffentlicht.
Was das für Ingenieure und Studios bedeutet
Bis zum Erscheinen von Rubin HPC ist es mehr als ein Jahr, und bislang ist das eine Ansage ohne Schlüsselzahlen. Der Beschreibung nach gliedert NVIDIA wissenschaftliche Berechnungen als eigene Richtung innerhalb der Plattform aus, statt sie vollständig den KI-Beschleunigern zu überlassen, bei denen doppelte Genauigkeit in der Regel keine Priorität hat. Simulationsspezialisten und Konstruktionsingenieuren könnte das Beschleuniger bringen, die besser zu ihren Aufgaben passen. Doch für die Entscheidung, ob man darauf Beschaffungen oder einen Wechsel in die Cloud planen sollte, ist es zu früh: Weder die Leistung in doppelter Genauigkeit noch Speicher, Preis oder Integrationspartner sind genannt.
Für Künstler, VFX-Studios und Spieleentwickler ändert die Ankündigung unmittelbar nichts. Ein indirekter Nutzen kann über Simulationspakete entstehen, die lernen, die neuen Fähigkeiten des Chips zu nutzen. Wahrscheinlich werden große Rechenzentren die Neuheit zuerst ausprobieren, so wie es bei den Vera-Prozessoren am DKRZ und bei TACC geschieht. Anbieter von CAE-Software, vor allem von CFD- und FEM-Solvern, werden ihren Code voraussichtlich an die Beschleunigung spärlich besetzter Daten anpassen müssen, und von der Geschwindigkeit dieser Arbeit wird abhängen, wann gewöhnliche Ingenieurabteilungen den Effekt spüren.
Welche Zahl zu Rubin HPC erwarten Sie von NVIDIA in erster Linie?
- Leistung in FP64
- Speichergröße