
LightX2V veröffentlicht Qwen-Image-2.1-Version, die mit 4 statt 40 Schritten auskommt
Das Team von LightX2V hat auf Hugging Face das Modell Qwen-Image-2.1-Lightning-v2-RL veröffentlicht. Es handelt sich um eine beschleunigte Version des Generators Qwen-Image-2.1, die Bilder in 4 Entrauschungsschritten erzeugt und bearbeitet. Das Basismodell benötigt im Vergleich der Entwickler 40. Das Modell hat 7 Mrd. Parameter und deckt drei Aufgaben ab: Generierung nach Text, Bearbeitung nach einer einzelnen Referenz und Zusammensetzen eines Bildes aus mehreren Referenzen.
Ein Künstler, der Kompositionsvarianten durchprobiert oder Dutzende Korrekturen an einem Bild durchspielt, bekommt zehnmal weniger Schritte pro Iteration. Das soll die Wartezeit verkürzen, auch wenn die Entwickler keine Messwerte in Sekunden angeben. Es gibt zwei wichtige Einschränkungen: Das Modell hat die nicht-kommerzielle Lizenz des Basismodells Qwen-Image-2.1 übernommen, und die Entwickler selbst weisen darauf hin, dass die Ergebnisse in einer Reihe von Fällen manuell überprüft werden müssen.
Was die schnelle Version kann
Das Modell basiert auf Lightning v2, der von LightX2V destillierten Version von Qwen-Image-2.1. Im neuen Release wurde sie mit Reinforcement Learning weiter trainiert, und zwar mit dem eigenen Werkzeug des Teams, LightX2V RL. Alle drei Modi arbeiten mit CFG = 1.0, dieser Wert ist im Release festgelegt.
- Text zu Bild. Beispiel aus der Modellkarte: eine Keramikteekanne neben einer Schale Orangen auf einem Holztisch, weiches Morgenlicht durchs Fenster, detaillierte Glasur.
- Bearbeitung nach einer einzelnen Referenz. Das Modell verändert das ausgewählte Detail und behält den Rest bei. Im Beispiel der Entwickler wird die Jacke einer Figur dunkelgrün umgefärbt, während der Prompt verlangt, Gesicht, Pose und Umgebung unverändert zu lassen.
- Generierung nach mehreren Referenzen. Das Modell setzt ein Bild aus verschiedenen Quellen zusammen. Im Beispiel zieht die Person vom ersten Bild die Jacke vom zweiten an, der Prompt verlangt, ihr Aussehen und das Design des Kleidungsstücks zu erhalten, und gibt einen einfachen Studiohintergrund vor. Die Referenzen müssen in derselben Reihenfolge übergeben werden, in der sie im Prompt genannt sind.
Die Beispiele in der Modellkarte sind auf eine Ausgabe von 1024 × 1024 ausgelegt. Für andere Seitenverhältnisse müssen beide Bildseiten ein Vielfaches von 32 sein.
Wie der Vergleich mit 40 Schritten aussieht
LightX2V hat mehrere Bildpaare aus den eigenen Testläufen veröffentlicht. In jedem Paar werden die originalen Qwen-Image-2.1-Gewichte mit 40 Schritten dem neuen Modell mit 4 Schritten gegenübergestellt. Die Bedingungen sind bei beiden Versionen identisch: CFG = 1.0, dieselben vollständigen erweiterten Prompts, dieselben Referenzen und eine Auflösung von 1024 × 1024. Die Ausgangsprompts sind offen zugänglich, etwa für die Szene „Delfin an brennender Küste“.
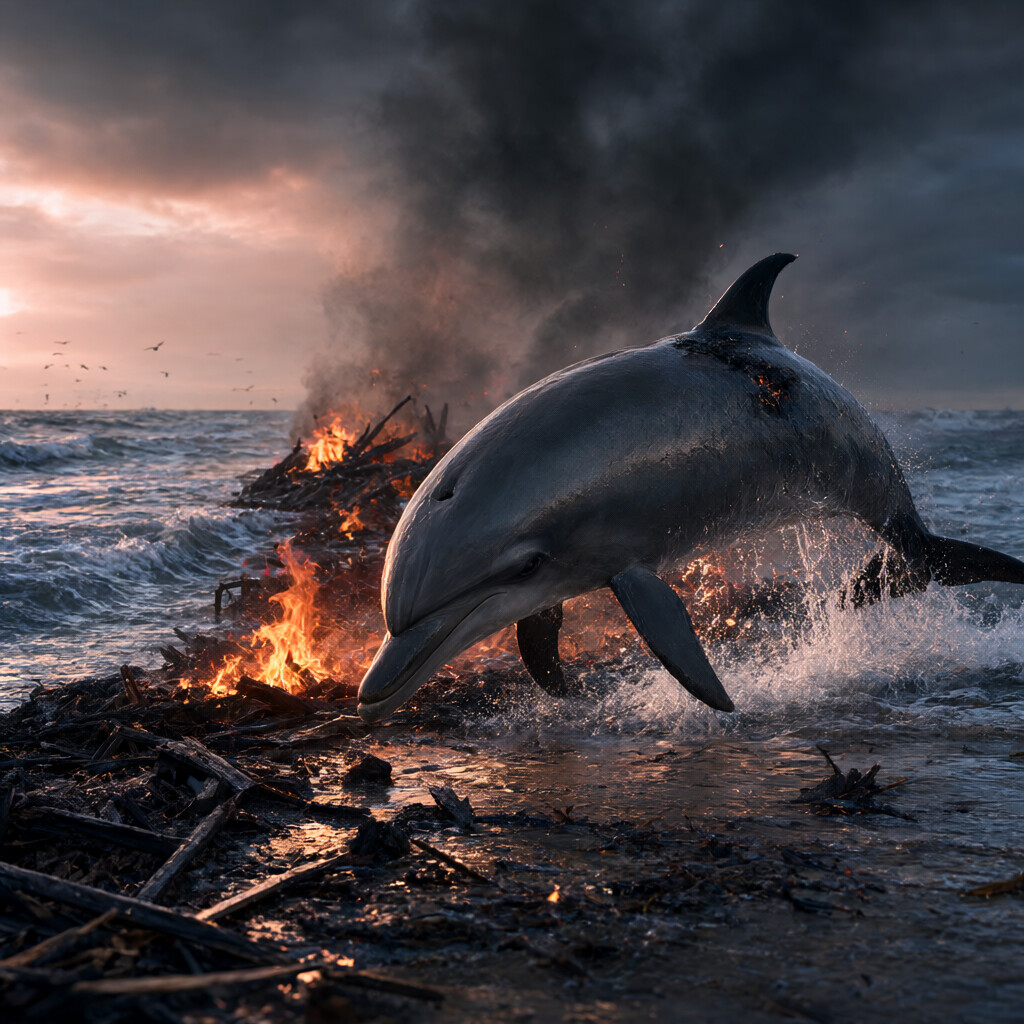
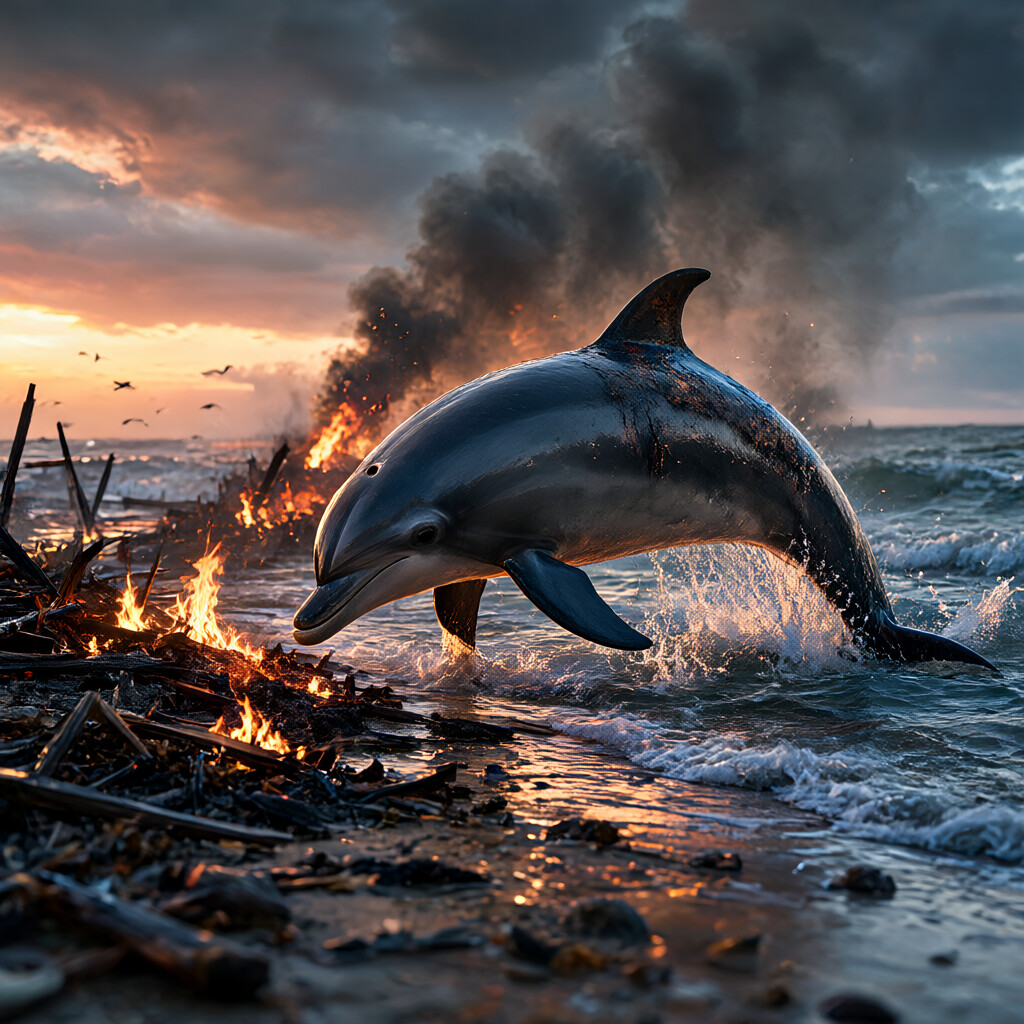
Im Bearbeitungsmodus nach Referenz gibt es zum Beispiel die Szene „Fliegender Drache über Gärten mit Wasserfällen“: Aus einem einzigen Ausgangsbild erzeugen beide Modelle nach der Beschreibung ein neues Bild.
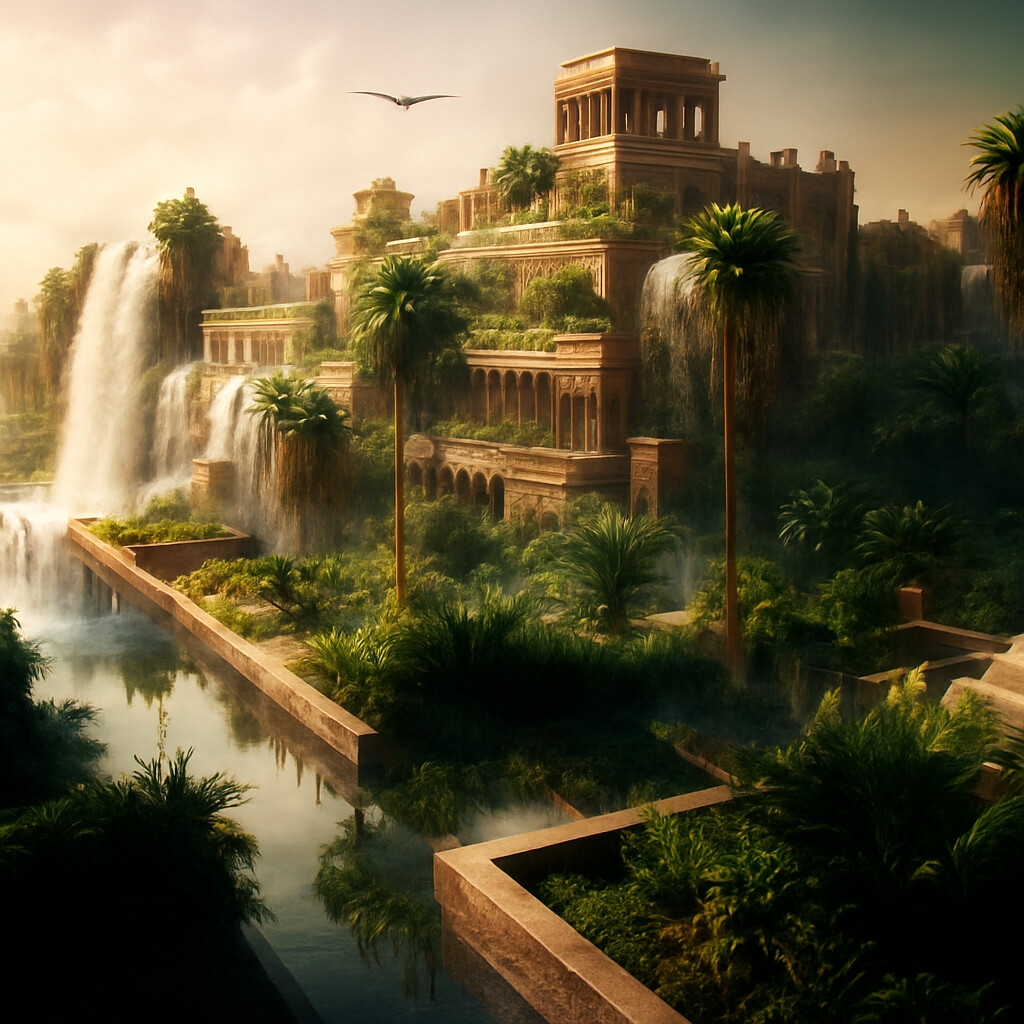
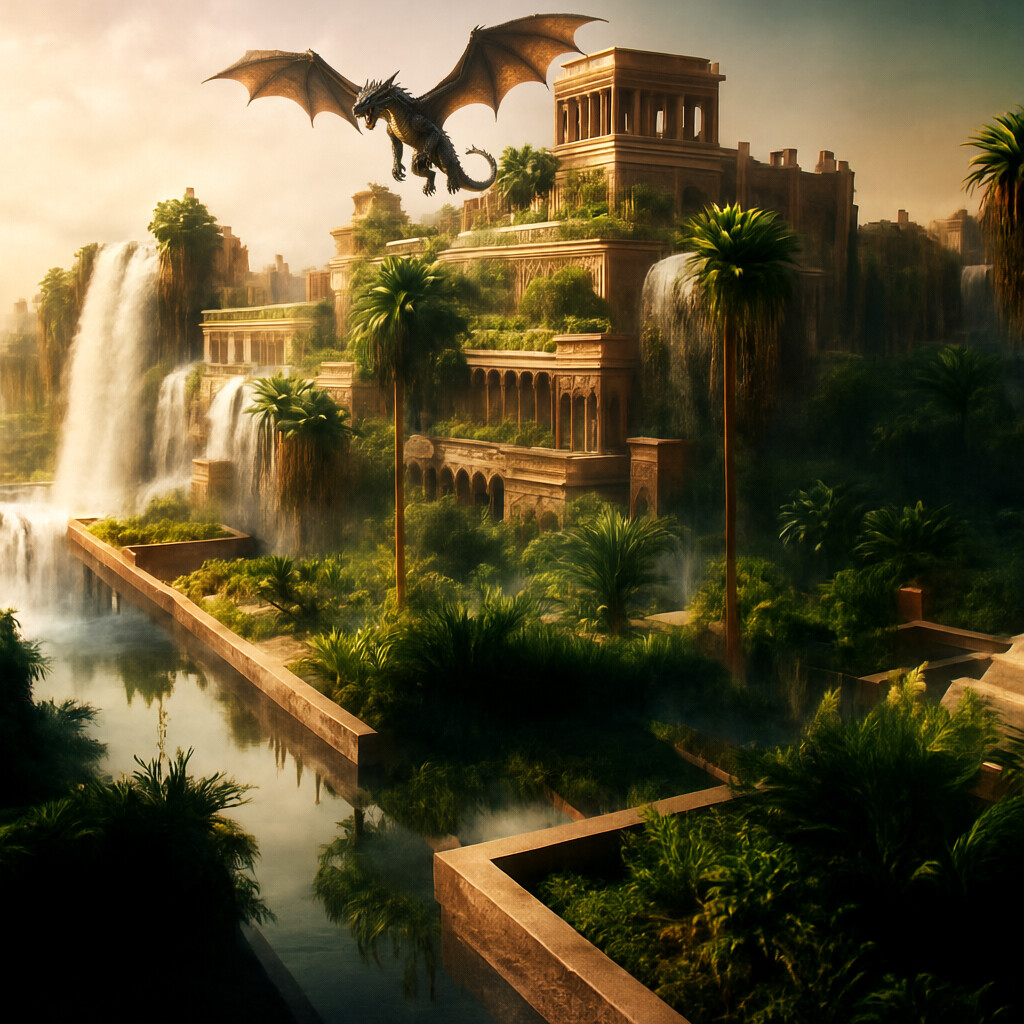
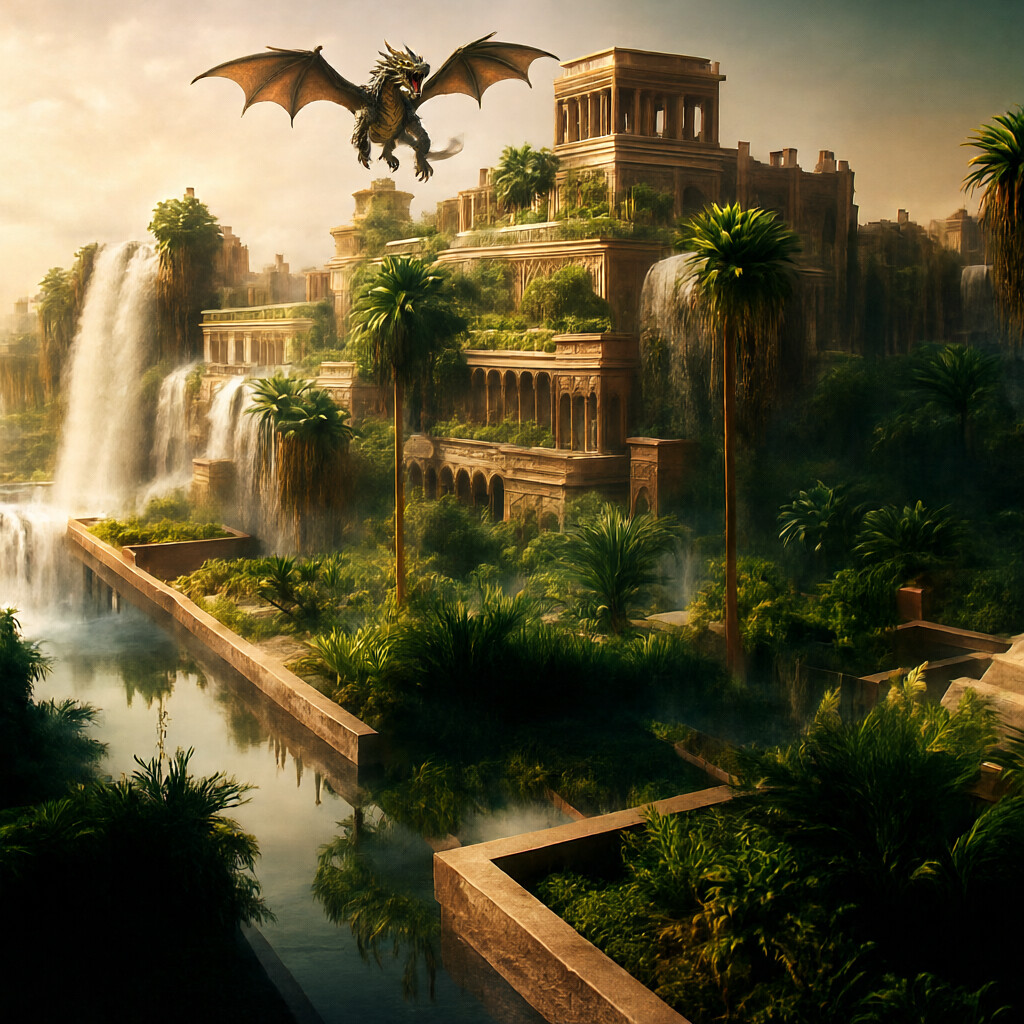
Dies sind ausgewählte Beispiele ohne numerische Qualitätsmetriken. Die Entwickler schreiben ausdrücklich, wo das Modell Fehler machen kann:
„Die Generierungsqualität kann je nach Prompt und Seed variieren; kleiner Text, Anatomie, Objektanzahl und die exakte Beibehaltung der Referenzen können noch eine Überprüfung erfordern.“
So ist es in der Modellkarte von LightX2V formuliert. Bei Aufgaben, bei denen Präzision zählt, etwa Aufschriften auf Verpackungen, die Hände einer Figur oder die Erkennbarkeit eines konkreten Produkts, muss das fertige Bild mit eigenen Augen geprüft werden.
Was man zum Start braucht
Das Release besteht aus einem vollständigen Gewichtssatz für den Hauptteil des Generators, den Transformer, in einer einzigen Datei im safetensors-Format. Es handelt sich nicht um einen LoRA-Adapter, und es muss nicht als Aufsatz über das Basismodell gelegt werden. Die übrigen Komponenten (Verarbeitung der Eingabedaten, Text-Encoder und VAE) werden aus der ursprünglichen Pipeline von Qwen-Image-2.1 übernommen und nach Bedarf von Hugging Face heruntergeladen.
- Die Gewichte liegen in FP32, für den Betrieb können sie in BF16 geladen werden.
- Erforderlich sind eine aktuelle Version der Bibliothek Diffusers mit Unterstützung für Qwen-Image-2.1 sowie die Bibliothek transformers mindestens in Version 5.17.0.
- Zusammen mit den Gewichten liegt eine separate Datei mit Inferenz-Einstellungen: Basismodell, vier Rauschpegel-Werte für die Schritte, Guidance-Stärke und Scheduler-Parameter. Diffusers greift diese Datei nicht selbst auf, sie wird vom Codebeispiel aus der Modellkarte gelesen.
- Der Schrittplan muss genau so verwendet werden, wie er im Release vorgegeben ist, und für alle drei Aufgaben gleich. Setzt man einfach die Schrittzahl auf vier, wird dieser Plan nicht reproduziert.
Der letzte Punkt betrifft alle, die das Modell in ihre eigenen Werkzeuge einbauen: Der Schrittplan muss exakt aus dem Release übernommen werden.
Lizenz und für wen das nützlich ist
Das Modell ist von Qwen-Image-2.1 abgeleitet, daher gilt für es die Qwen Research License einschließlich ihrer nicht-kommerziellen Bedingungen. Die Lizenz erlaubt die Nutzung nur zu Forschungs- und Evaluierungszwecken, für den kommerziellen Einsatz verlangt sie eine separate Lizenz des Rechteinhabers. Für ein Studio oder einen Freelancer bedeutet das: Das Modell eignet sich für Experimente und interne Tests, aber nicht für Kundenaufträge.
Im letzten Monat wurde das Modell 1449 Mal heruntergeladen, und die Basisversion Qwen-Image-2.1 hat auf Hugging Face 88 nachtrainierte Ableitungen. Die Neuheit gehört zu einer LightX2V-Kollektion aus fünf Positionen, die Qwen-Image-2.1 gewidmet ist. Als verwandte Arbeiten verweisen die Entwickler auf ihr früheres Release Qwen-Image-2.1-Lightning und auf Qwen-Image-2.1-Turbo vom Qwen-Team.
Was im Release noch fehlt
Die Anzahl der Schritte ist nicht gleich der Generierungszeit: Messwerte in Sekunden und Anforderungen an den Videospeicher gibt die Modellkarte nicht an. Zur Unterstützung von ComfyUI ist ebenfalls nichts gesagt, und der offizielle Weg zum Start führt bislang über Python-Code und Diffusers. Solange keine Nodes für knotenbasierte Umgebungen erscheinen, wird das Modell wohl in erster Linie technischen Künstlern und Pipeline-Entwicklern zugutekommen, die es selbst in ihre Werkzeuge einbauen. Allen anderen ist zu empfehlen, für die direkte Arbeit auf Integrationen zu warten.
Ohne eigene Vergleiche bleibt auch unklar, wie sich das neue Modell zur Turbo-Version von Qwen und zum ersten Lightning verhält. Die Entwickler zeigen nur den Vergleich mit dem Basismodell bei 40 Schritten, die Wahl zwischen den beschleunigten Varianten muss man also anhand eigener Aufgaben und eigener Prompts treffen.
Werden 4 Schritte zum neuen Standard für offene Modelle, oder lässt die nicht-kommerzielle Lizenz die Destillation von LightX2V ein Nischenspielzeug bleiben?