
LightX2V 发布 Qwen-Image-2.1 版本,4 步即可替代 40 步
LightX2V 团队在 Hugging Face 上公开了 Qwen-Image-2.1-Lightning-v2-RL 模型。这是生成器 Qwen-Image-2.1 的加速版本,只需 4 个去噪步骤就能生成和编辑图像。在开发者的对比中,基础模型需要 40 步。该模型有 70 亿参数,涵盖三项任务:按文本生成、按单张参考图修改,以及用多张参考图合成画面。
对于要反复尝试构图方案、或对同一个画面跑几十次修改的美术师来说,每次迭代的步数少了十倍。这应该会缩短等待时间,不过开发者没有给出以秒计的实测数据。有两个重要限制:该模型继承了基础版 Qwen-Image-2.1 的非商业许可,而开发者本人也提醒,有些情况下结果需要人工检查。
快速版本能做什么
该模型基于 Lightning v2,即 LightX2V 对 Qwen-Image-2.1 的蒸馏版本。在新版本中,团队用自研工具 LightX2V RL,以强化学习方法对它做了进一步训练。三种模式都在 CFG = 1.0 下工作,这一数值在发布版中已经设定。
- 文本生成图像。模型卡中的示例:木桌上一只陶瓷茶壶,旁边是一碗橙子,柔和的晨光从窗户照入,釉面细节丰富。
- 按单张参考图修改。模型改动选定的细节,其余部分保持不变。在开发者的示例中,人物的外套被改成深绿色,而提示词要求脸部、姿态和环境保持原样。
- 按多张参考图生成。模型用不同素材合成画面。示例中,第一张图里的人穿上了第二张图里的外套,提示词要求保留他的外貌和衣物的设计,并指定了简单的影棚背景。参考图的输入顺序要与提示词中提到的顺序一致。
模型卡中的示例针对 1024 × 1024 的输出。若使用其他画面比例,画面的两条边都必须是 32 的倍数。
与 40 步的对比是什么样
LightX2V 公开了自家验证运行中的若干组图像对比。每一组都是 40 步的原始 Qwen-Image-2.1 权重与 4 步的新模型相对照。两个版本的条件完全相同:CFG = 1.0、同样完整的扩写提示词、同样的参考图以及 1024 × 1024 的分辨率。原始提示词是公开的,例如“燃烧海岸边的海豚”这一场景。
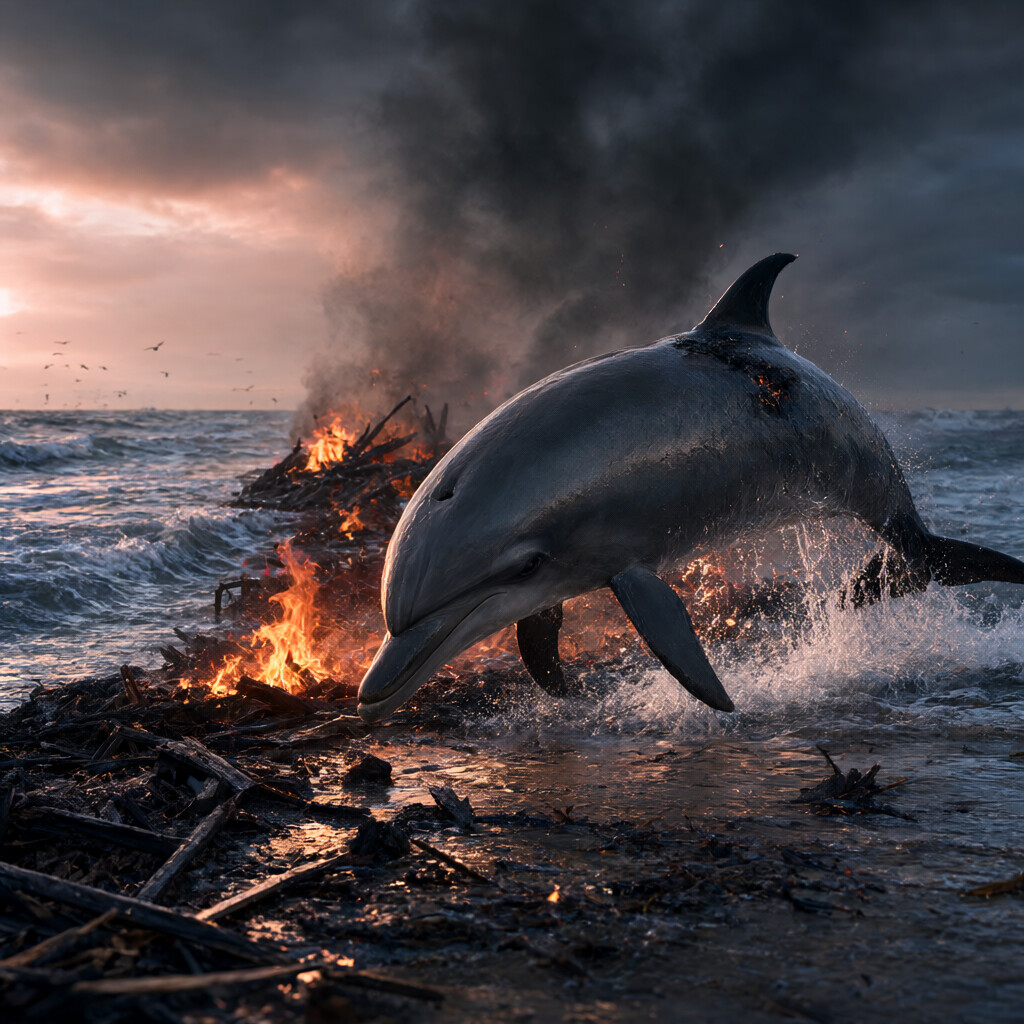
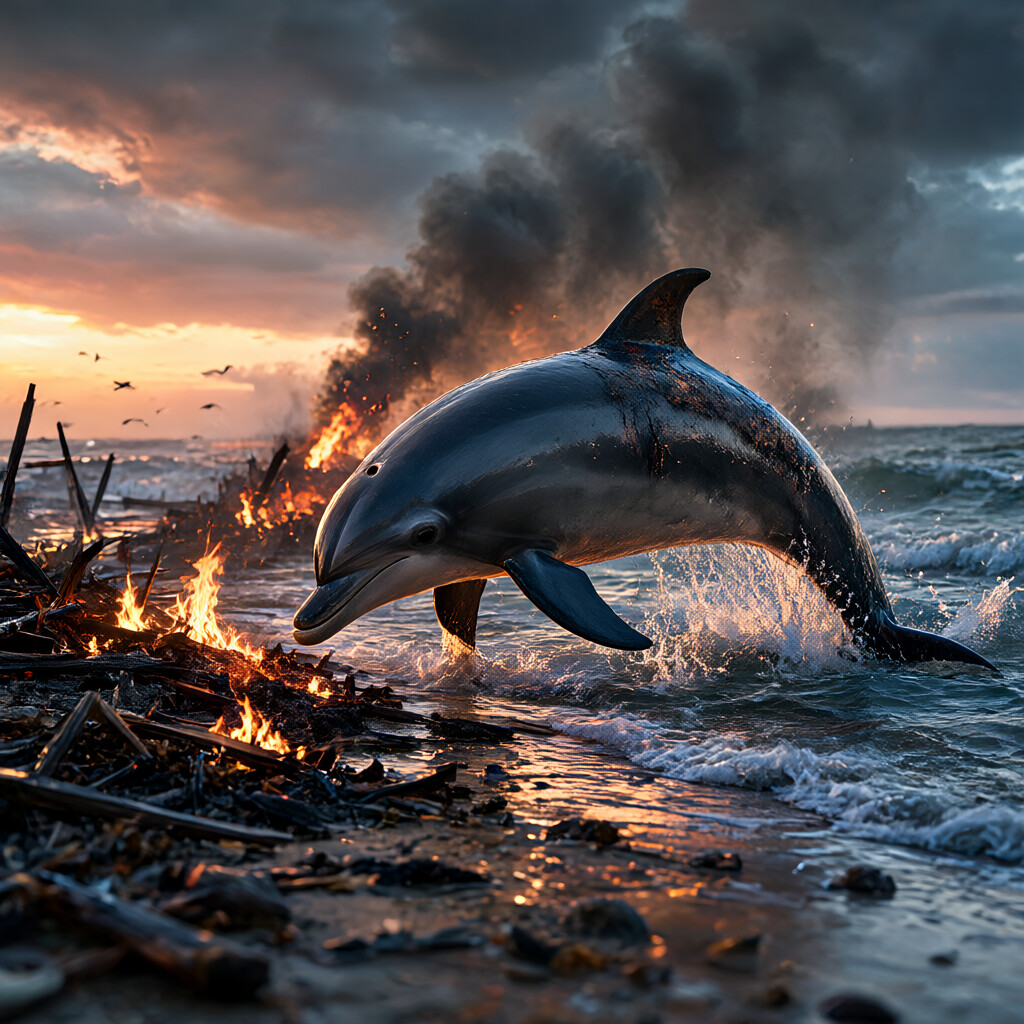
在按参考图修改的模式中,还有例如“飞龙掠过瀑布花园”这一场景:两个模型都从同一张原图出发,按描述构建出新的画面。
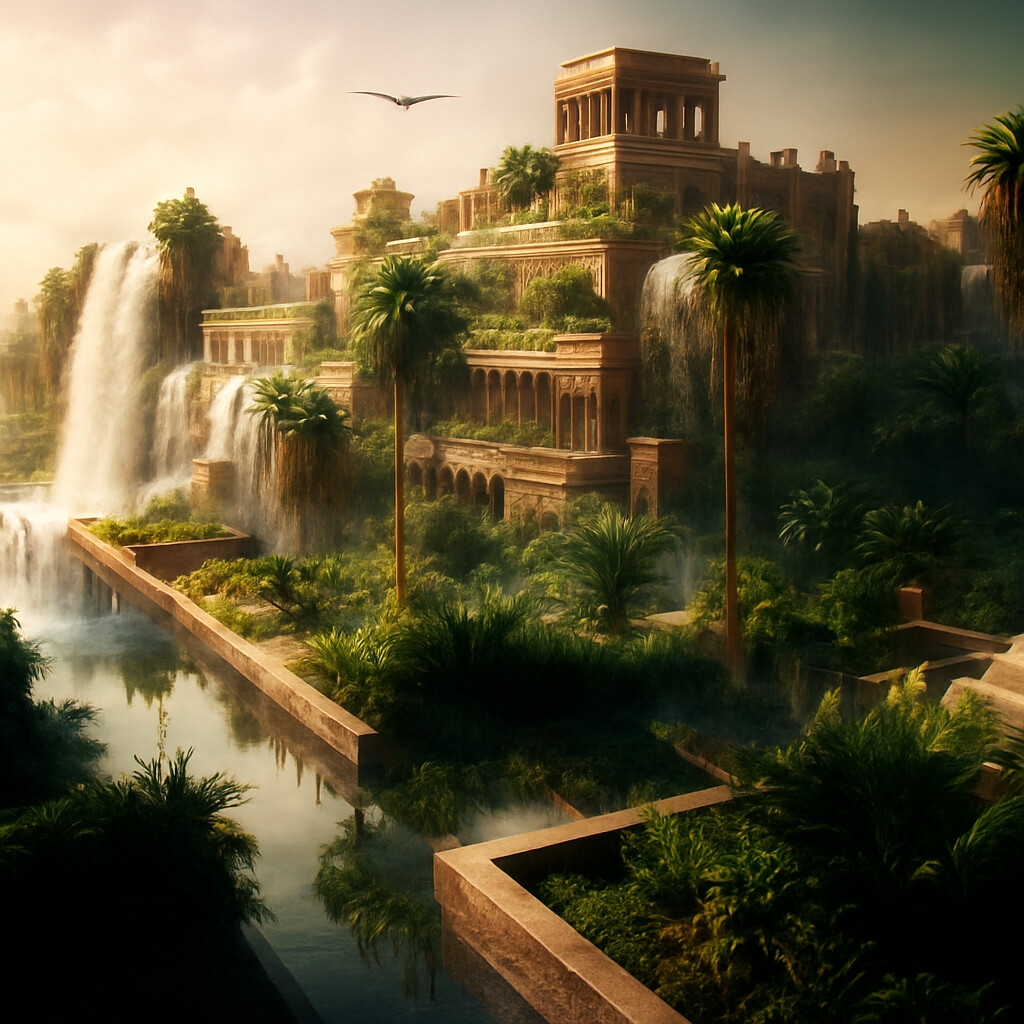
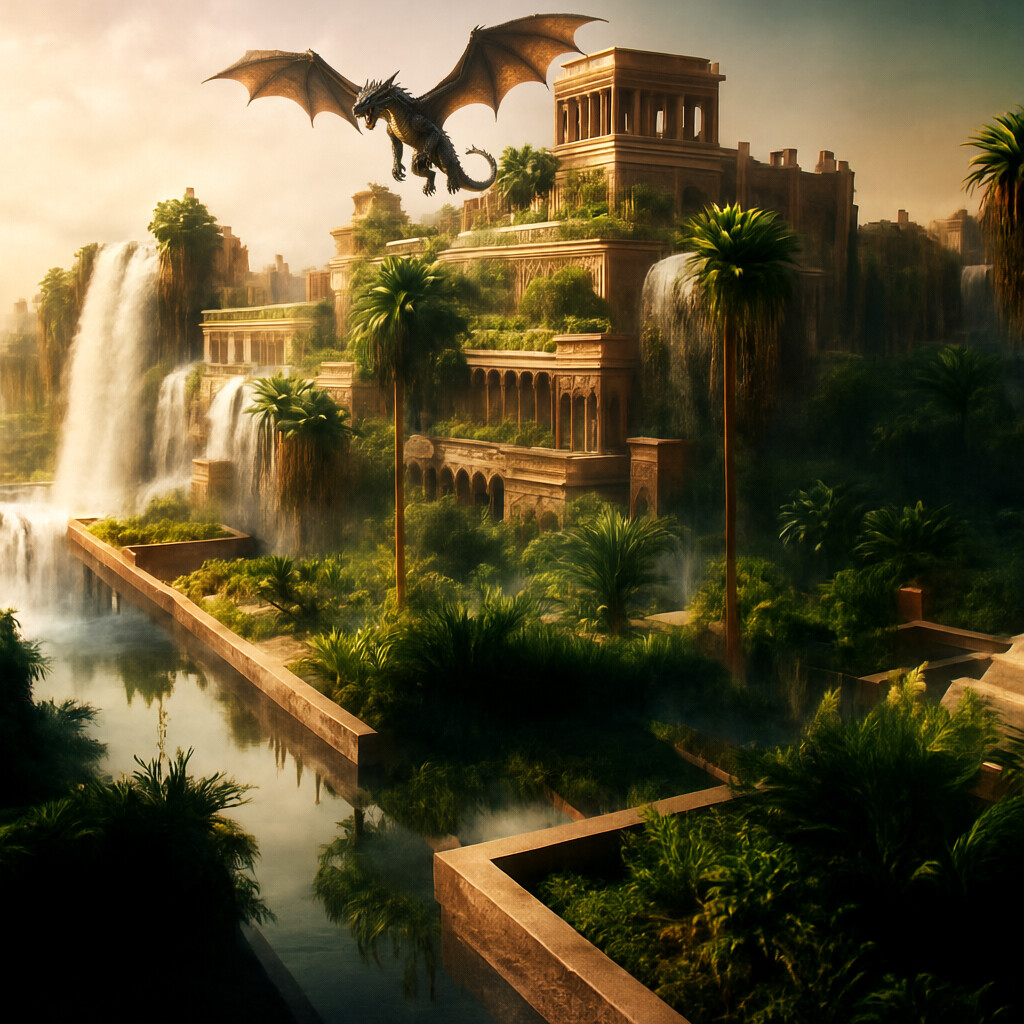
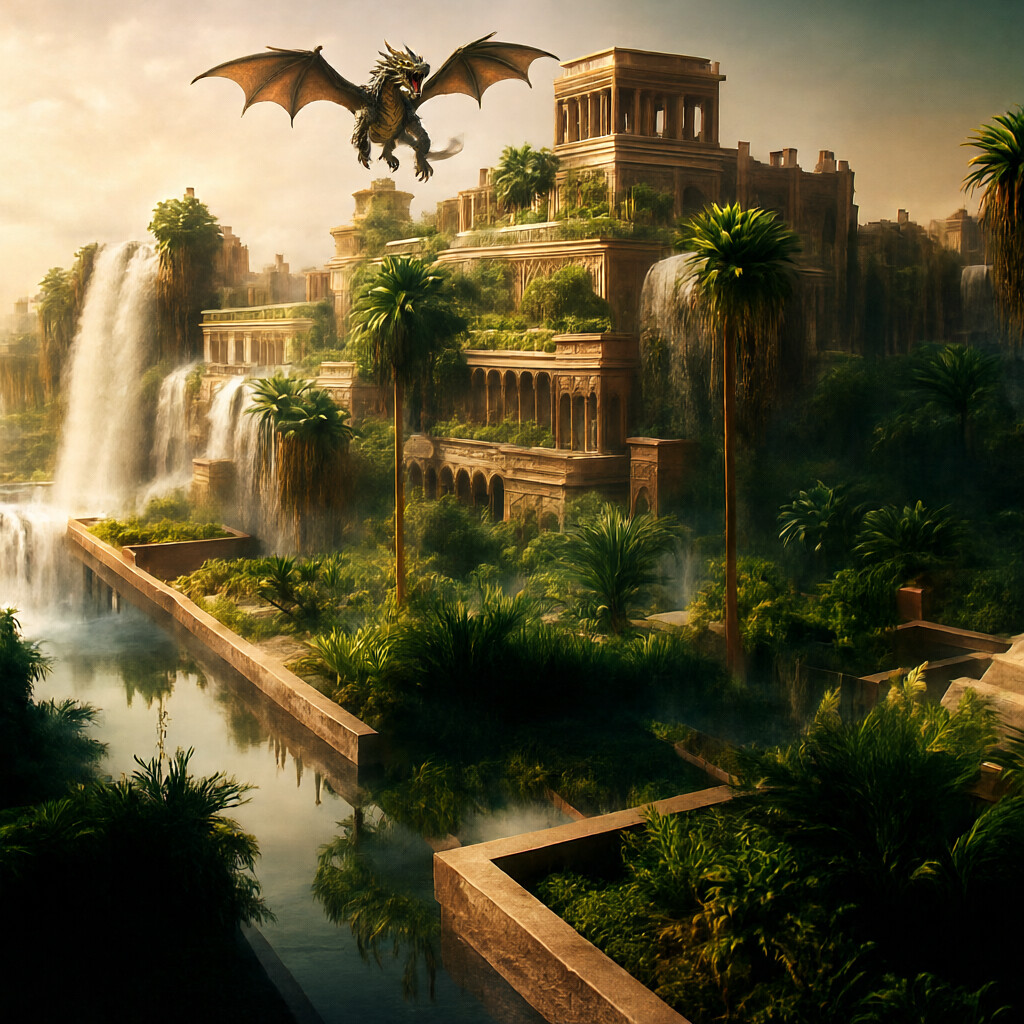
这些是经过挑选的示例,没有量化的质量指标。开发者直接写明了模型可能出错的地方:
“生成质量可能因提示词和种子而异;小号文字、解剖结构、物体数量以及对参考图的精确保留仍可能需要检查。”
LightX2V 的模型卡中就是这样表述的。在对精确度有要求的任务中,比如包装上的文字、人物的手、某个具体商品的辨识度,最终画面还是得靠眼睛去核对。
运行需要什么
此次发布的是生成器主体部分,即 transformer 的完整权重,装在一个 safetensors 格式的文件里。它不是 LoRA 适配器,也不需要作为附加件挂在基础模型之上。其余组件(输入数据处理器、文本编码器和 VAE)取自 Qwen-Image-2.1 原始流程,按需从 Hugging Face 下载。
- 权重以 FP32 存储,运行时可以按 BF16 加载。
- 需要支持 Qwen-Image-2.1 的较新版本 Diffusers 库,以及不低于 5.17.0 版本的 transformers 库。
- 权重旁附有一个单独的推理设置文件:基础模型、四个步骤对应的噪声水平数值、guidance 强度以及调度器参数。Diffusers 本身不会读取这个文件,读取它的是模型卡中的示例代码。
- 步骤调度必须严格使用发布版中设定的那一套,并且三项任务都用同一套。如果只是把步数设为 4,这套调度是无法复现的。
最后一点关系到所有要把该模型集成进自家工具的人:调度必须原样从发布版中搬过来。
许可及适用人群
该模型派生自 Qwen-Image-2.1,因此适用 Qwen Research License,包括其非商业条款。该许可仅允许用于研究和评估目的,商业应用需要向权利人另行取得许可。对工作室或自由职业者来说,这意味着模型适合做实验和内部测试,但不能用于客户订单。
过去一个月该模型被下载了 1449 次,而基础版 Qwen-Image-2.1 在 Hugging Face 上有 88 个微调衍生模型。这款新作属于 LightX2V 围绕 Qwen-Image-2.1 整理的一个包含五个条目的合集。作为相关工作,开发者提到了自家更早的发布 Qwen-Image-2.1-Lightning,以及 Qwen 团队的 Qwen-Image-2.1-Turbo。
此次发布尚未提供的内容
步数不等于生成时间:模型卡没有给出以秒计的实测数据,也没有显存需求。关于 ComfyUI 的支持同样没有任何说明,目前官方的运行途径是通过 Python 代码和 Diffusers。在节点式环境的节点出现之前,这个模型大概首先会落到技术美术和流程开发者手里,由他们自己把它接进自家工具。其他人若想直接上手,不妨等待相关集成。
由于没有独立对比,新模型与 Qwen 的 Turbo 版本以及第一代 Lightning 相比如何同样不清楚。开发者只展示了与 40 步基础模型的对比,因此在各个加速版本之间做选择,还得靠自己的任务和自己的提示词。
4 步会成为开源模型的新标准,还是非商业许可会让 LightX2V 的蒸馏模型停留在小众玩物的位置?