
LightX2V, 40스텝 대신 4스텝으로 충분한 Qwen-Image-2.1 버전 공개
LightX2V 팀이 Hugging Face에 Qwen-Image-2.1-Lightning-v2-RL 모델을 공개했다. 이미지를 4번의 노이즈 제거 스텝으로 생성하고 편집하는, Qwen-Image-2.1 생성기의 가속 버전이다. 개발진의 비교에서 기본 모델은 40스텝이 필요하다. 모델의 파라미터는 70억 개이며, 텍스트 기반 생성, 단일 레퍼런스 기반 편집, 여러 레퍼런스를 조합한 화면 구성이라는 세 가지 작업을 담당한다.
구도 변형을 여러 개 시도하거나 한 컷에 수십 번 수정을 돌리는 아티스트는 반복 작업마다 스텝 수가 10분의 1로 줄어든다. 대기 시간이 단축될 것으로 보이지만, 개발진은 초 단위 측정치를 제시하지 않았다. 중요한 제약이 두 가지 있다. 모델은 기본 Qwen-Image-2.1의 비상업용 라이선스를 그대로 물려받았고, 개발진 스스로도 경우에 따라 결과물을 직접 확인해야 한다고 경고한다.
빠른 버전이 할 수 있는 일
이 모델은 LightX2V가 Qwen-Image-2.1을 증류한 버전인 Lightning v2를 기반으로 한다. 새 릴리스에서는 팀 자체 도구인 LightX2V RL을 이용해 강화학습 방식으로 추가 학습했다. 세 가지 모드 모두 CFG = 1.0에서 작동하며, 이 값은 릴리스에 지정되어 있다.
- 텍스트에서 이미지로. 모델 카드의 예시: 나무 테이블 위 오렌지가 담긴 그릇 옆의 세라믹 찻주전자, 창에서 들어오는 부드러운 아침 햇빛, 디테일한 유약.
- 단일 레퍼런스 기반 편집. 모델은 선택한 디테일만 바꾸고 나머지는 유지한다. 개발진의 예시에서는 인물의 재킷을 다크 그린으로 바꾸는데, 프롬프트는 얼굴과 포즈, 주변 환경을 그대로 두라고 요구한다.
- 여러 레퍼런스 기반 생성. 모델은 서로 다른 소스에서 화면을 조합한다. 예시에서는 첫 번째 그림의 사람이 두 번째 그림의 재킷을 입는데, 프롬프트는 인물의 외형과 옷의 디자인을 유지하라고 요구하고 단순한 스튜디오 배경을 지정한다. 레퍼런스는 프롬프트에서 언급된 순서와 같은 순서로 입력해야 한다.
카드의 예시는 1024 × 1024 출력을 기준으로 한다. 다른 화면비에서는 화면의 두 변 모두 32의 배수여야 한다.
40스텝과의 비교는 어떤 모습인가
LightX2V는 자체 검증 실행에서 나온 이미지 몇 쌍을 공개했다. 각 쌍에서는 40스텝의 원본 Qwen-Image-2.1 가중치와 4스텝의 새 모델이 대조된다. 두 버전의 조건은 동일하다. CFG = 1.0, 동일한 전체 확장 프롬프트, 동일한 레퍼런스, 1024 × 1024 해상도다. 원본 프롬프트는 공개되어 있는데, 예를 들어 「불타는 해변의 돌고래」 장면이 그렇다.
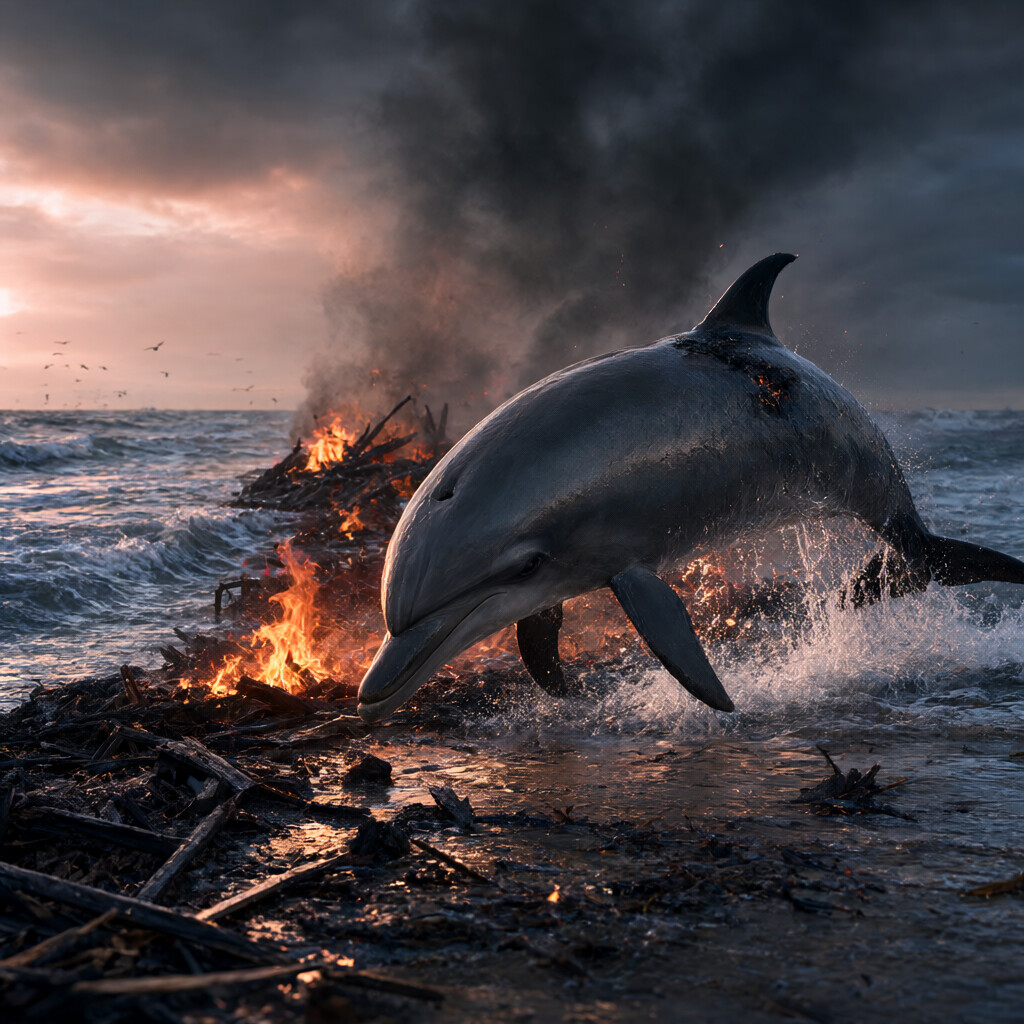
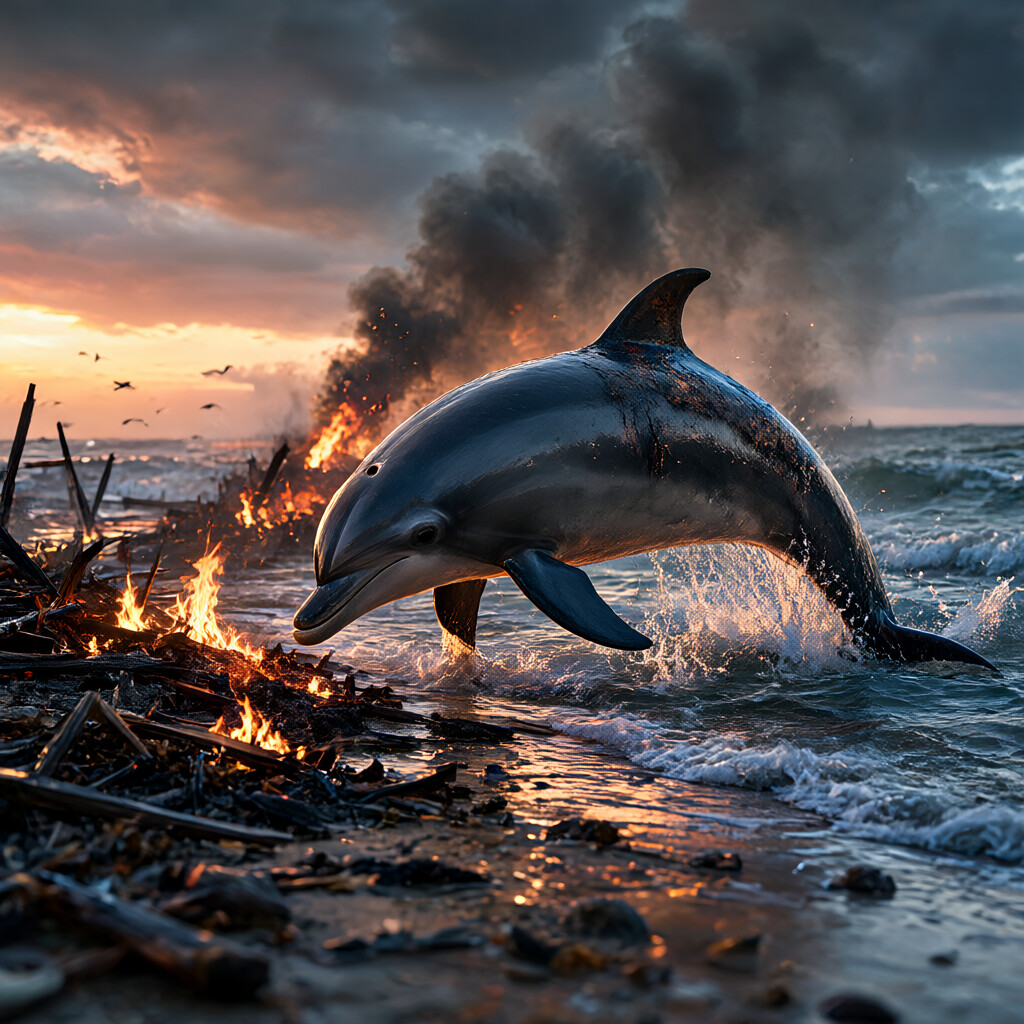
레퍼런스 기반 편집 모드에는 예를 들어 「폭포가 있는 정원 위를 나는 용」 장면이 있다. 두 모델 모두 하나의 원본 이미지에서 설명에 따라 새로운 화면을 만들어낸다.
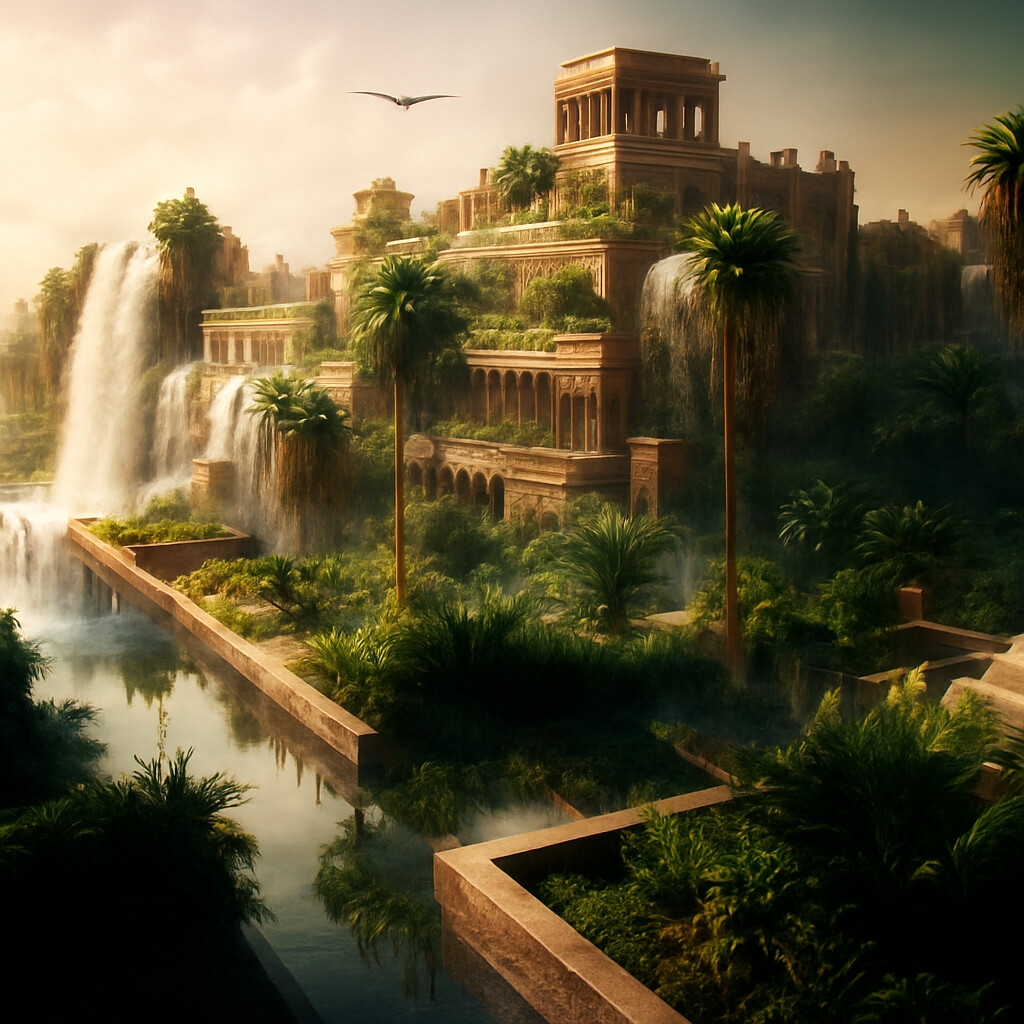
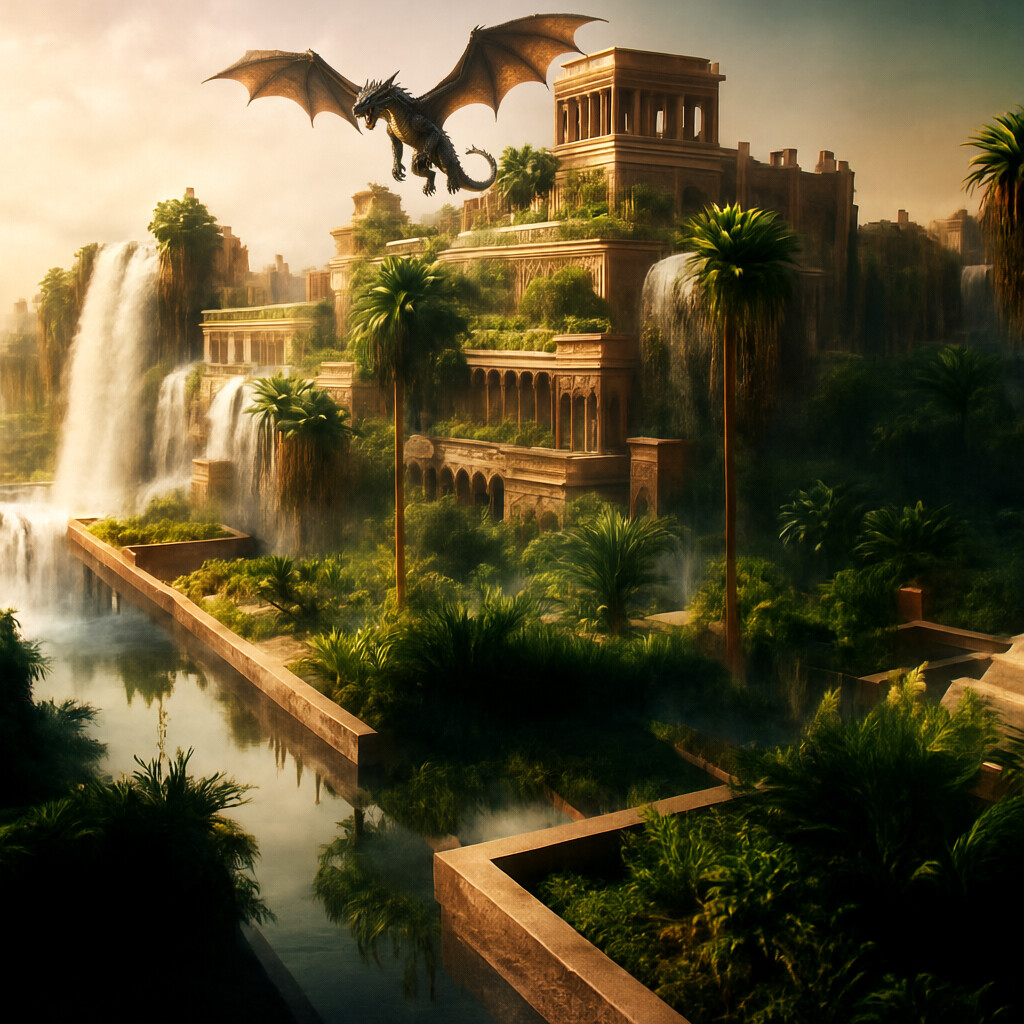
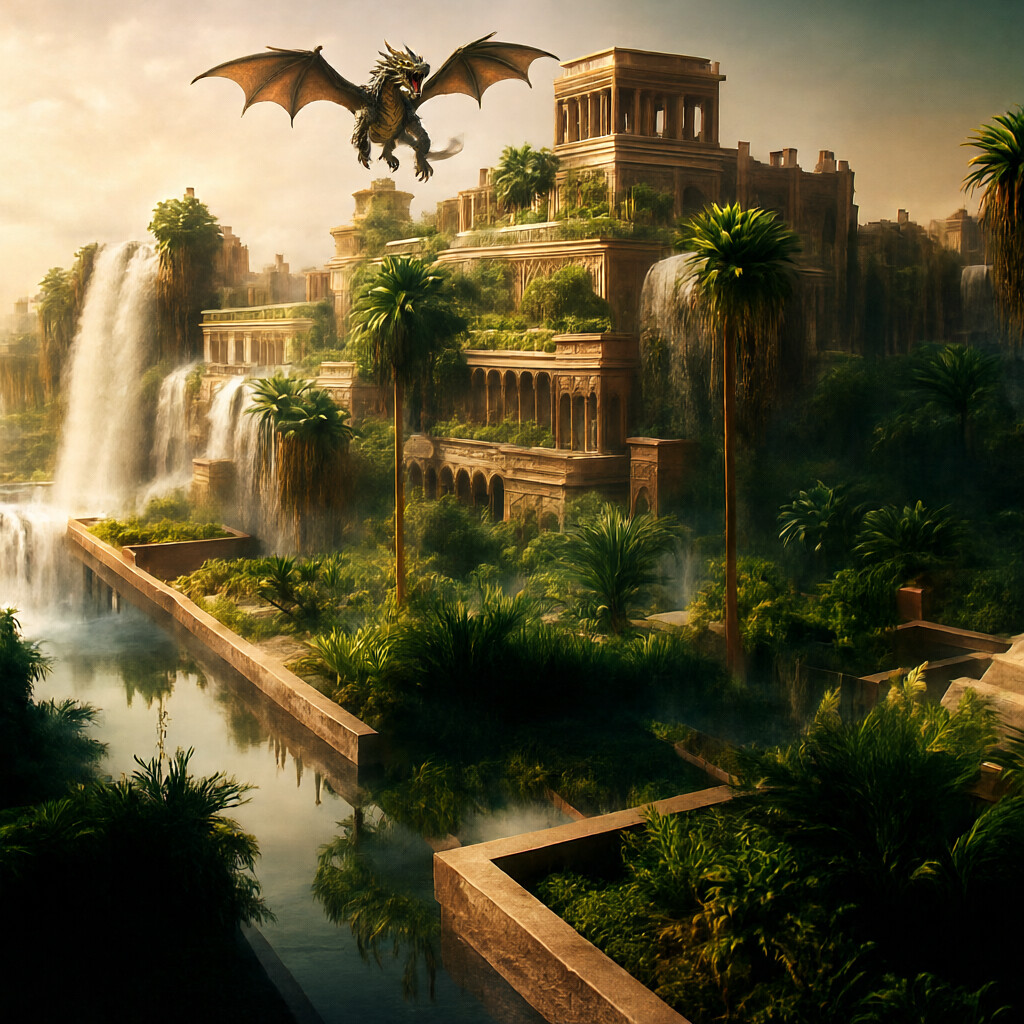
이는 선별된 예시이며 수치화된 품질 지표는 없다. 개발진은 모델이 틀릴 수 있는 지점을 직접 밝히고 있다.
「생성 품질은 프롬프트와 시드에 따라 달라질 수 있으며, 작은 텍스트, 해부학적 구조, 객체 수, 레퍼런스의 정확한 유지는 여전히 확인이 필요할 수 있다」.
LightX2V의 모델 카드에 이렇게 적혀 있다. 포장재의 문구, 인물의 손, 특정 제품의 식별성처럼 정확성이 중요한 작업에서는 최종 이미지를 눈으로 직접 확인해야 한다.
실행에 필요한 것
이번 릴리스는 생성기의 핵심 부분인 트랜스포머의 가중치 전체를 safetensors 형식 파일 하나에 담은 것이다. LoRA 어댑터가 아니며, 기본 모델 위에 추가 레이어처럼 얹을 필요가 없다. 나머지 구성 요소(입력 데이터 처리기, 텍스트 인코더, VAE)는 원본 Qwen-Image-2.1 파이프라인에서 가져오며 필요에 따라 Hugging Face에서 내려받는다.
- 가중치는 FP32로 저장되어 있고, 작동 시에는 BF16으로 로드할 수 있다.
- Qwen-Image-2.1을 지원하는 최신 버전의 Diffusers 라이브러리와 5.17.0 이상 버전의 transformers 라이브러리가 필요하다.
- 가중치와 함께 추론 설정이 담긴 별도 파일이 들어 있다. 기본 모델, 스텝별 노이즈 레벨 값 4개, guidance 강도, 스케줄러 파라미터가 그 내용이다. Diffusers는 이 파일을 자동으로 읽지 않고, 카드의 코드 예시가 읽어 들인다.
- 스텝 스케줄은 릴리스에 지정된 것을 그대로 사용해야 하며, 세 작업 모두 동일하다. 단순히 스텝 수를 4로 설정하는 것으로는 이 스케줄이 재현되지 않는다.
마지막 항목은 모델을 자신의 도구에 통합하려는 모든 이에게 해당된다. 스케줄은 릴리스에서 정확히 그대로 옮겨와야 한다.
라이선스와 활용 대상
이 모델은 Qwen-Image-2.1의 파생물이므로 비상업용 조항을 포함한 Qwen Research License가 적용된다. 라이선스는 연구와 평가 목적의 사용만 허용하며, 상업적 활용에는 권리자로부터 별도 라이선스를 받아야 한다. 스튜디오나 프리랜서에게는 이 모델이 실험과 내부 테스트에는 적합하지만 클라이언트 작업에는 쓸 수 없다는 뜻이다.
지난 한 달간 이 모델은 1449회 다운로드됐고, 기본 Qwen-Image-2.1은 Hugging Face에서 88개의 추가 학습 파생 모델을 보유하고 있다. 신작은 Qwen-Image-2.1을 다룬 5개 항목으로 구성된 LightX2V 컬렉션에 포함된다. 개발진은 관련 작업으로 자신들의 이전 릴리스 Qwen-Image-2.1-Lightning과 Qwen 팀의 Qwen-Image-2.1-Turbo를 언급한다.
릴리스에 아직 없는 것
스텝 수가 생성 시간과 같은 것은 아니다. 모델 카드는 초 단위 측정치도, 비디오 메모리 요구 사항도 제시하지 않는다. ComfyUI 지원에 대해서도 언급이 없으며, 공식적인 실행 경로는 현재 Python 코드와 Diffusers를 거친다. 노드 기반 환경용 노드가 나오기 전까지는 이 모델이 우선 테크니컬 아티스트와 파이프라인 개발자, 즉 직접 자신의 도구에 조립해 넣을 사람들의 몫이 될 가능성이 크다. 나머지 사용자는 직접 작업하려면 통합을 기다리는 편이 합리적이다.
독자적인 비교가 없으니 새 모델이 Qwen의 Turbo 버전과 첫 Lightning에 비해 어떤 수준인지도 불분명하다. 개발진은 40스텝 기본 모델과의 비교만 보여주기 때문에, 가속 버전들 사이의 선택은 각자의 작업과 각자의 프롬프트로 해야 할 것이다.
4스텝이 오픈 모델의 새로운 표준이 될까, 아니면 비상업용 라이선스 탓에 LightX2V의 증류 모델이 틈새 장난감으로 남을까?