Lightricks devuelve luces y sombras al vídeo de 8 bits
Investigadores de Lightricks han mostrado una forma de obtener vídeo HDR a partir de un clip SDR corriente de 8 bits. El modelo generativo de vídeo no se reentrena para ello: sus pesos y el codificador quedan congelados. Los fotogramas se entregan en la codificación logarítmica ACEScct, conocida por los coloristas de los pipelines de cine, y solo se entrena un pequeño adaptador. Este reconstruye los detalles en luces y sombras que se perdieron al grabar en 8 bits.
El método se llama LumiVid. A la salida se obtiene una secuencia de EXR scene-linear en half-float de 16 bits, es decir, material pensado para corrección de color y composición. La exposición se puede cambiar después en posproducción, sin volver a generar nada.
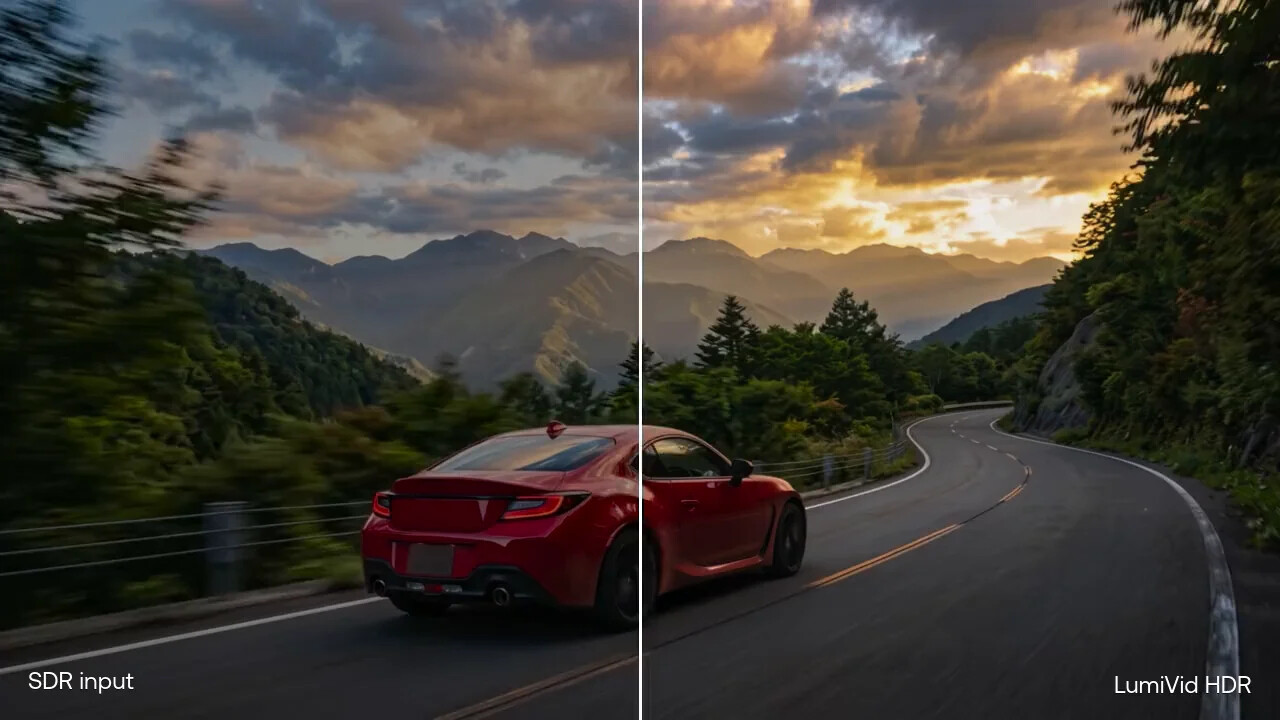
«Un pequeño adaptador aprende a rellenar las luces y las sombras que recorta el vídeo de 8 bits».
Así describe Lightricks la esencia del enfoque en su blog técnico.
Por qué el vídeo generativo aguanta mal el etalonaje
Los autores nombran el problema directamente: los modelos de difusión de vídeo trabajan en SDR de 8 bits. En HDR se almacena el brillo continuo de la escena, y el colorista puede bajar la exposición en una ventana quemada o levantar un rincón oscuro. En un fotograma de 8 bits, en el lugar de la ventana ya hay una mancha blanca, y en las sombras, una caída al negro. Allí no hay nada que levantar. Por eso el clip generado se monta mal con material HDR rodado y soporta mal una corrección seria.
Los autores dividen en dos grupos las formas existentes de adaptar modelos al HDR. Unas cambian el espacio latente del codificador: para HDR se entrena una nueva representación, y eso supone complejidad extra y grandes exigencias de datos. Otras se apoyan en entradas auxiliares: máscaras de brillo, prompts de texto, imágenes de referencia externas. Según los investigadores, esto añade trabajo manual, un prompt preciso es difícil de encontrar, y el resultado es menos estable y a menudo se aparta del material original. LumiVid se arregla con un solo clip SDR en la entrada.
Cómo el logaritmo sustituye a un modelo nuevo
La observación clave del trabajo es la siguiente: la codificación logarítmica comprime el HDR en una distribución que coincide bien con aquella con la que el modelo de vídeo ya ha sido entrenado. El modelo no tiene que asimilar un nuevo tipo de datos. Basta con un ligero reentrenamiento del adaptador, y el codificador se mantiene igual. Según los datos de los autores, para el entrenamiento bastaron unos 300 pares sintéticos de clips de 49 fotogramas cada uno, montados sobre escenas de Poly Haven.
La segunda parte del método se refiere al entrenamiento. Para que el modelo deduzca por sí mismo los detalles ausentes, los autores degradan los fotogramas SDR de entrada igual que los degrada una cámara: recortan el contraste, difuminan luces y sombras, añaden artefactos de compresión MP4 y desplazan la exposición. El modelo no puede copiar píxeles y restaura el rango dinámico apoyándose en lo que ya sabe del mundo. En la página del proyecto se ha publicado una comparación de tres variantes: sin esa aumentación, solo con desenfoque y el modelo completo.
Allí mismo se muestra un experimento de control, útil para entender el método. Si se pasa el material solo por el decodificador, sin el propio modelo de vídeo, la exposición se puede subir, pero los detalles en las luces no se restauran, y no hay estabilidad entre fotogramas. De ahí se deduce que es el modelo generativo el que reconstruye la información perdida.
Qué se puede comprobar uno mismo
En la página del proyecto se reúnen resultados SDR→HDR para vídeo y para fotogramas sueltos. Un visor interactivo permite desplazar la exposición hasta −3 EV para comprobar las luces, y hasta +3 EV para mirar las sombras. Allí LumiVid se compara con tres métodos:
- Tedla et al. según la receta oficial: 17 fotogramas a una resolución de 704×1280; después, este método mantiene el último fotograma mientras LumiVid continúa;
- HDRTVNet++: procesa los fotogramas de uno en uno y luego se unen en un vídeo;
- DiffHDR: según la receta oficial, con EXR lineales en Rec.709 a la salida.
Para la muestra, el resultado de LumiVid se convierte de EXR ACEScct a Rec.709 con una subida de 2 EV y después a BT.2020 HLG. El SDR original se mantiene en Rec.709. Además de la comparación visual, los autores aportan también una medición: en material cinematográfico de cámaras ARRI, LumiVid aventaja a los mejores métodos existentes en 5,5 dB según la métrica PU21-PSNR. La descripción completa del método está en el artículo en arXiv. Sus autores son el equipo de Lightricks, Mohamed Oumoumad de Gear Productions, y también Or Patashnik y Daniel Cohen-Or de la Universidad de Tel Aviv.
A quién le servirá y qué falta todavía
A juzgar por la descripción, el método se dirige en primer lugar a coloristas y compositores que insertan planos generados en material real. Ahora mismo, en el montaje, un plano así se comporta a menudo como algo ajeno: las luces altas clipean, las sombras no se levantan. Los EXR scene-linear a la salida probablemente permitirán etalonarlo con las mismas herramientas que el material rodado. Como a la entrada se entrega un clip SDR corriente, en teoría el enfoque también es aplicable a material SDR ya existente, pero los autores no analizan ese escenario por separado.
En los productos de Lightricks el terreno ya está preparado para ello. En la documentación de LTX hay una sección sobre el trabajo con EXR y HDR: el modo Native HDR acepta OpenEXR scene-linear o ACEScct, fotogramas y secuencias, y devuelve HDR con gestión de color, para que el material siga hacia la composición y el finishing. Para las fuentes SDR se menciona allí un escenario aparte, SDR to HDR, con sus propios modelos. Si está relacionado precisamente con LumiVid no se precisa en los materiales publicados.
También hay limitaciones. En los materiales publicados no se indican los requisitos de tarjeta gráfica ni el tiempo de procesado, ni información sobre si se publicará el código de LumiVid en concreto. Los detalles de las luces quemadas los reconstruye el modelo a partir de representaciones aprendidas: en el fotograma original esos datos no están. Resulta un detalle verosímil, pero inventado, y para el trabajo de VFX, donde importa la fidelidad real del fotograma, conviene tenerlo en cuenta.
¿Aceptarán los coloristas y los supervisores de VFX un detalle inventado por el modelo en las luces, o seguirá siendo demasiado arriesgado para el finishing?