
LightX2V lanza una versión de Qwen-Image-2.1 a la que le bastan 4 pasos en lugar de 40
El equipo de LightX2V ha publicado en Hugging Face el modelo Qwen-Image-2.1-Lightning-v2-RL. Es una versión acelerada del generador Qwen-Image-2.1 que crea y edita imágenes en 4 pasos de eliminación de ruido. En la comparación de los desarrolladores, el modelo base necesita 40. El modelo tiene 7000 millones de parámetros y cubre tres tareas: generación a partir de texto, edición a partir de una sola referencia y composición de un fotograma a partir de varias referencias.
Un artista que prueba variantes de composición o ejecuta decenas de correcciones sobre un mismo fotograma obtiene diez veces menos pasos por cada iteración. Esto debería reducir el tiempo de espera, aunque los desarrolladores no aportan mediciones en segundos. Hay dos limitaciones importantes: el modelo heredó la licencia no comercial del Qwen-Image-2.1 base y los propios desarrolladores advierten de que en varios casos habrá que revisar los resultados manualmente.
Qué sabe hacer la versión rápida
El modelo está construido sobre Lightning v2, la versión destilada de Qwen-Image-2.1 de LightX2V. En el nuevo lanzamiento se la entrenó de nuevo con aprendizaje por refuerzo mediante la propia herramienta del equipo, LightX2V RL. Los tres modos funcionan con CFG = 1.0, valor fijado en el lanzamiento.
- Texto a imagen. Ejemplo de la ficha del modelo: una tetera de cerámica junto a un cuenco de naranjas sobre una mesa de madera, luz matinal suave que entra por la ventana, esmalte detallado.
- Edición a partir de una sola referencia. El modelo cambia el detalle elegido y conserva el resto. En el ejemplo de los desarrolladores, la chaqueta de un personaje se repinta de verde oscuro, mientras el prompt exige dejar iguales la cara, la pose y el entorno.
- Generación a partir de varias referencias. El modelo compone un fotograma a partir de distintas fuentes. En el ejemplo, la persona de la primera imagen se pone la chaqueta de la segunda; el prompt exige conservar su aspecto y el diseño de la prenda y fija un fondo de estudio simple. Las referencias deben suministrarse en el mismo orden en que se nombran en el prompt.
Los ejemplos de la ficha están pensados para una salida de 1024 × 1024. Para otras relaciones de aspecto, ambos lados del fotograma deben ser múltiplos de 32.
Cómo es la comparación con 40 pasos
LightX2V ha publicado varios pares de imágenes de sus pasadas de verificación. En cada par se contraponen los pesos originales de Qwen-Image-2.1 con 40 pasos y el nuevo modelo con 4 pasos. Las condiciones son iguales en ambas versiones: CFG = 1.0, los mismos prompts ampliados completos, las mismas referencias y una resolución de 1024 × 1024. Los prompts de origen están abiertos, por ejemplo para la escena «Delfín junto a una costa en llamas».
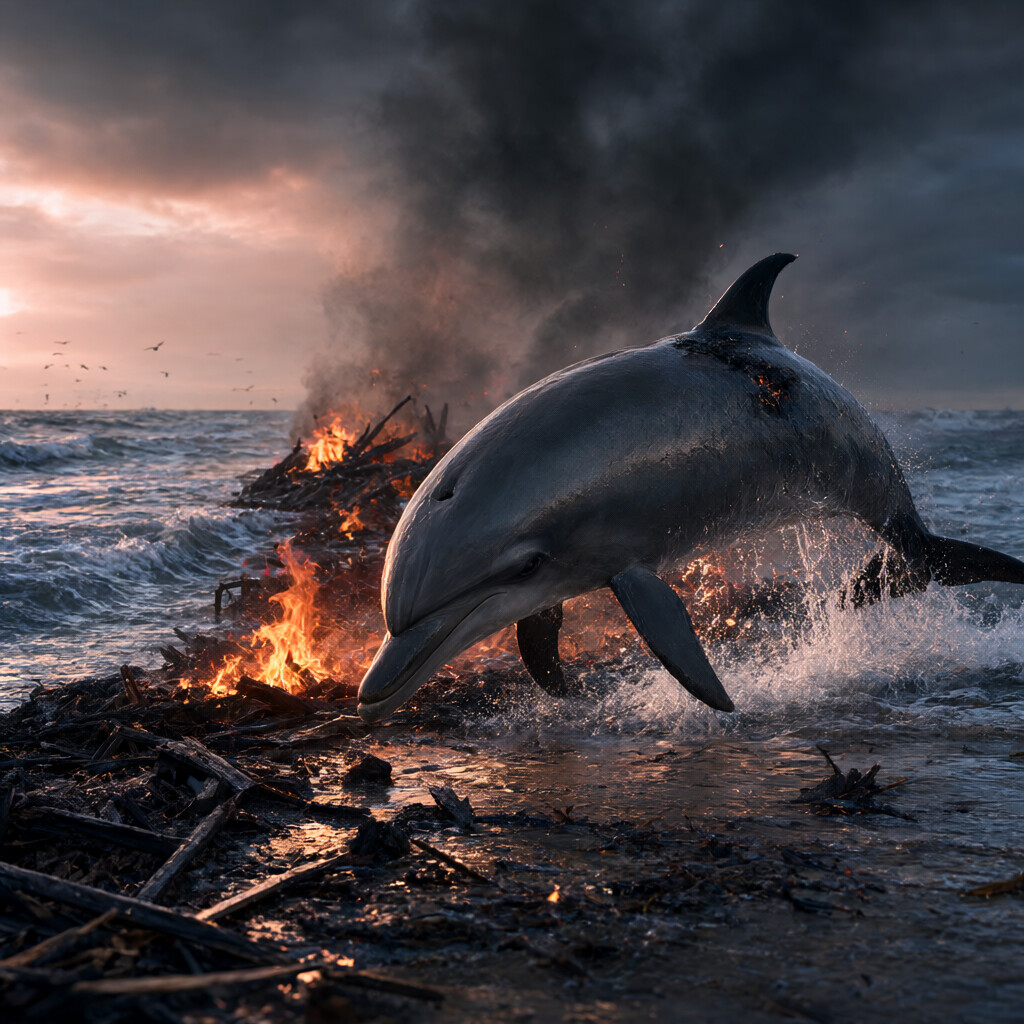
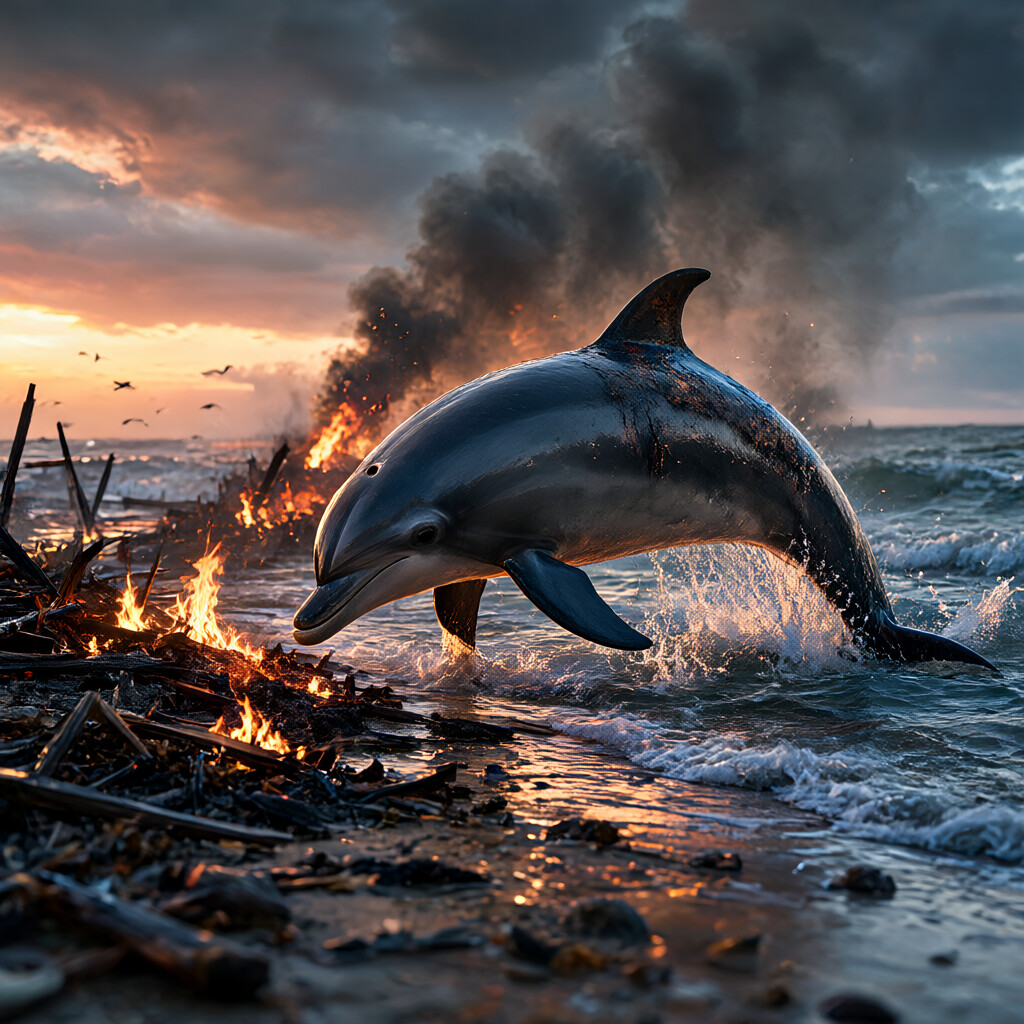
En el modo de edición a partir de referencia hay, por ejemplo, la escena «Dragón volando sobre jardines con cascadas»: a partir de una sola imagen de origen, ambos modelos construyen un nuevo fotograma según la descripción.
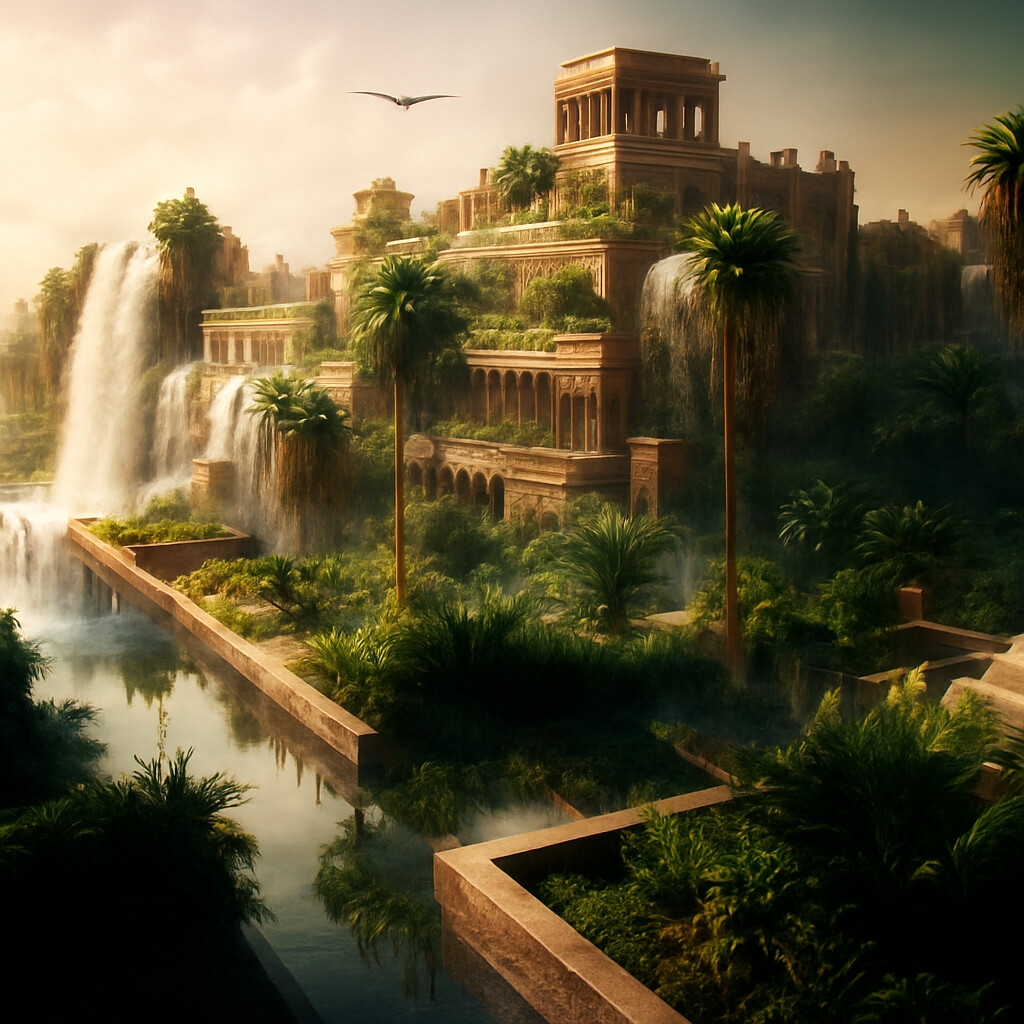
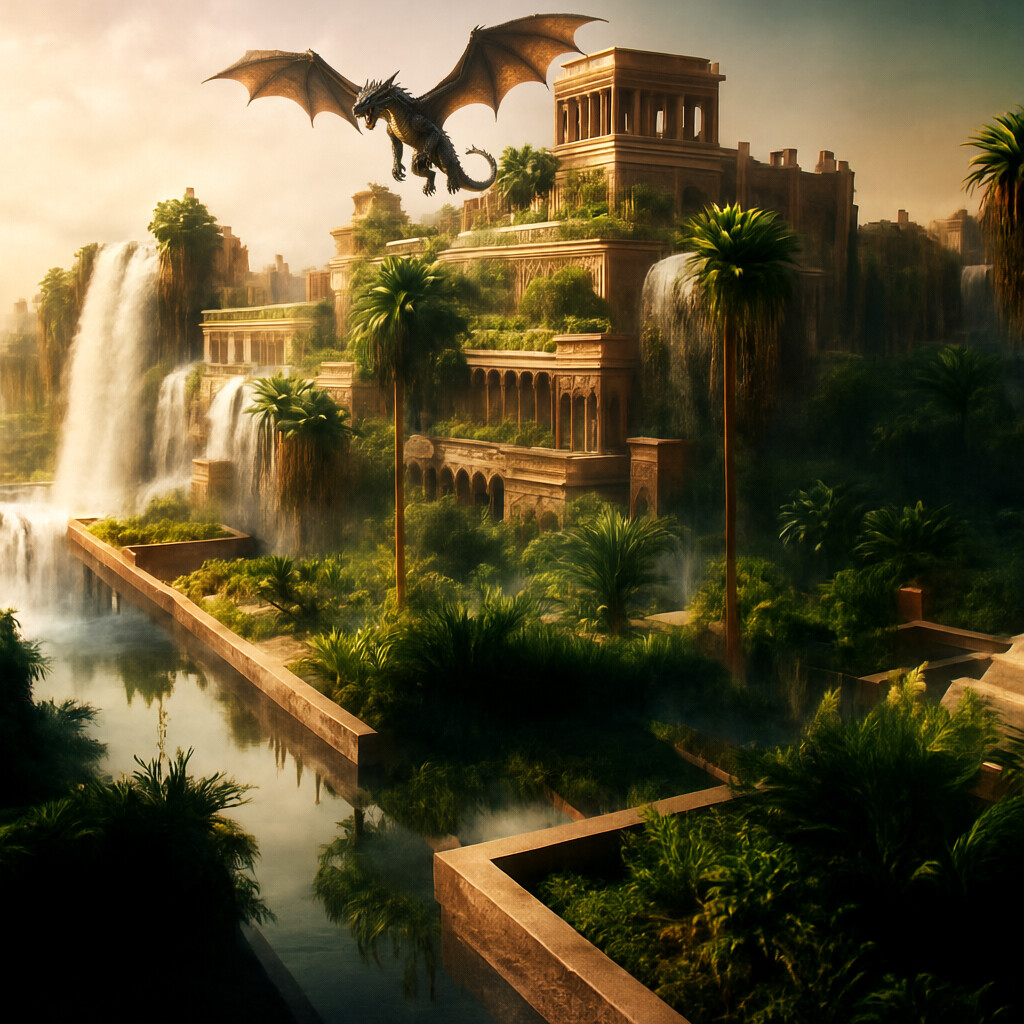
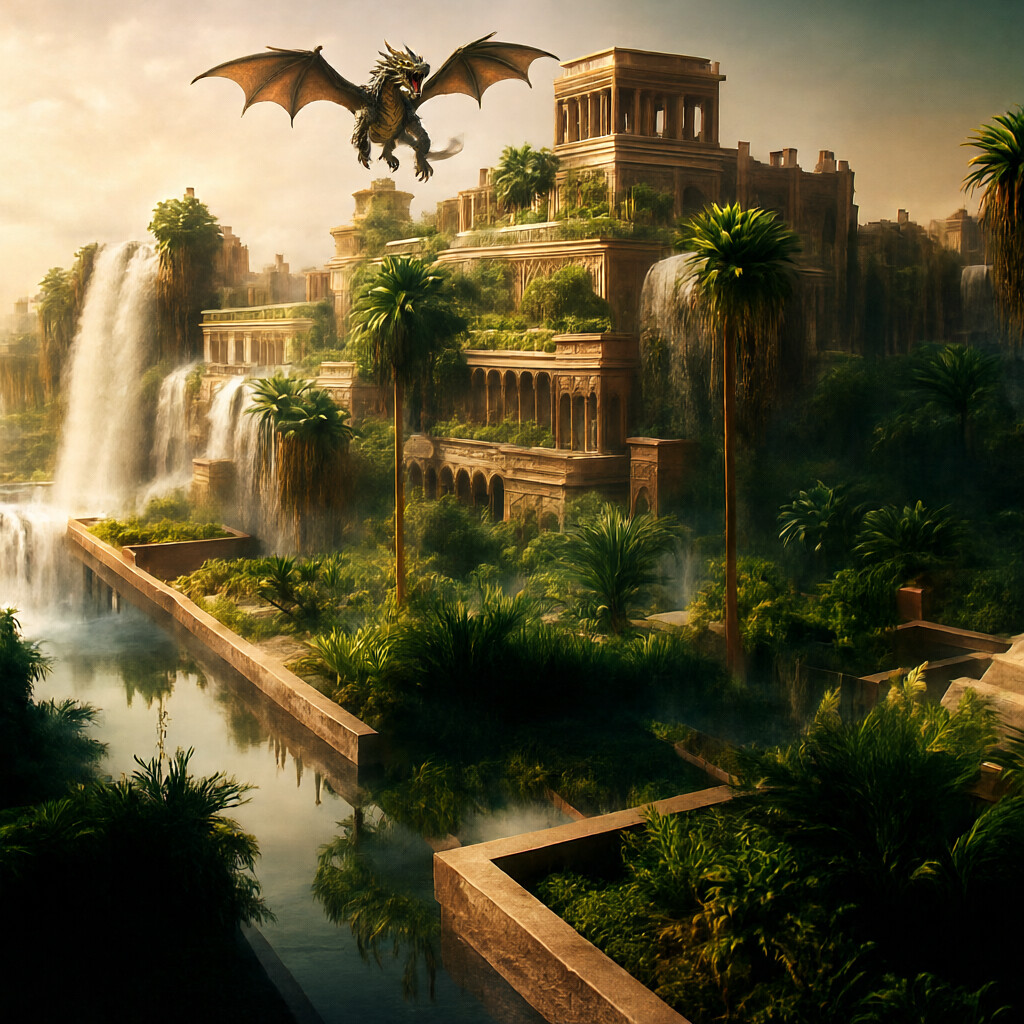
Son ejemplos seleccionados sin métricas numéricas de calidad. Los desarrolladores escriben abiertamente dónde el modelo puede equivocarse:
«La calidad de generación puede variar según el prompt y la semilla; el texto pequeño, la anatomía, el número de objetos y la conservación exacta de las referencias todavía pueden requerir verificación».
Así está formulado en la ficha del modelo de LightX2V. En tareas donde importa la precisión, por ejemplo las inscripciones en un envase, las manos de un personaje o el reconocimiento de un producto concreto, la imagen final habrá que revisarla con los propios ojos.
Qué se necesita para ponerlo en marcha
El lanzamiento consiste en un conjunto completo de pesos de la parte principal del generador, el transformador, en un único archivo en formato safetensors. No es un adaptador LoRA y no hace falta acoplarlo sobre el modelo base como un añadido. El resto de los componentes (el procesador de datos de entrada, el codificador de texto y el VAE) se toman del pipeline original de Qwen-Image-2.1 y se descargan de Hugging Face según sea necesario.
- Los pesos se almacenan en FP32 y para trabajar se pueden cargar en BF16.
- Se necesita una versión reciente de la biblioteca Diffusers con soporte de Qwen-Image-2.1 y la biblioteca transformers no inferior a la versión 5.17.0.
- Junto a los pesos hay un archivo aparte con los ajustes de inferencia: modelo base, cuatro valores de nivel de ruido para los pasos, fuerza del guidance y parámetros del planificador. Diffusers no recoge este archivo por sí solo, lo lee el ejemplo de código de la ficha.
- Hay que usar exactamente el programa de pasos fijado en el lanzamiento, y el mismo para las tres tareas. Si simplemente se pone el número de pasos en cuatro, ese programa no se reproduce.
El último punto afecta a todos los que vayan a integrar el modelo en sus propias herramientas: el programa habrá que trasladarlo del lanzamiento con exactitud.
Licencia y a quién le servirá esto
El modelo es derivado de Qwen-Image-2.1, por lo que se le aplica la Qwen Research License, incluidas sus condiciones no comerciales. La licencia permite el uso solo con fines de investigación y evaluación, y para la aplicación comercial exige una licencia aparte del titular de los derechos. Para un estudio o un autónomo esto significa que el modelo sirve para experimentos y pruebas internas, pero no para encargos de clientes.
En el último mes el modelo se ha descargado 1449 veces, y el Qwen-Image-2.1 base tiene en Hugging Face 88 derivados reentrenados. La novedad forma parte de una colección de LightX2V de cinco posiciones dedicada a Qwen-Image-2.1. Como trabajos afines, los desarrolladores remiten a su lanzamiento anterior Qwen-Image-2.1-Lightning y a Qwen-Image-2.1-Turbo del equipo de Qwen.
Qué falta todavía en el lanzamiento
El número de pasos no equivale al tiempo de generación: la ficha del modelo no aporta mediciones en segundos ni requisitos de memoria de vídeo. Sobre el soporte de ComfyUI tampoco se dice nada, y la vía oficial de ejecución pasa por ahora por código en Python y Diffusers. Hasta que no aparezcan nodos para los entornos nodales, el modelo probablemente le llegue en primer lugar a los artistas técnicos y a los desarrolladores de pipelines, que lo integrarán ellos mismos en sus herramientas. A los demás, para trabajar directamente, tiene sentido esperar a las integraciones.
Sin comparaciones propias tampoco queda claro cómo se sitúa el nuevo modelo frente a la versión Turbo de Qwen y frente al primer Lightning. Los desarrolladores muestran solo la comparación con el modelo base a 40 pasos, así que habrá que elegir entre las variantes aceleradas con las propias tareas y los propios prompts.
¿Se convertirán los 4 pasos en el nuevo estándar de los modelos abiertos, o la licencia no comercial dejará la destilación de LightX2V como un juguete de nicho?