Lightricks devolve luzes e sombras ao vídeo de 8 bits
Investigadores da Lightricks mostraram uma forma de obter vídeo HDR a partir de um clipe SDR comum de 8 bits. O modelo generativo de vídeo não é retreinado para isso: os seus pesos e o codificador ficam congelados. Os fotogramas entram na codificação logarítmica ACEScct, conhecida pelos coloristas dos pipelines de cinema, e treina-se apenas um pequeno adaptador. Ele reconstrói os detalhes nas luzes e nas sombras que se perderam ao gravar em 8 bits.
O método chama-se LumiVid. À saída obtém-se uma sequência de EXR scene-linear em half-float de 16 bits, isto é, material concebido para correção de cor e composição. A exposição pode depois ser alterada já na pós-produção, sem nova geração.
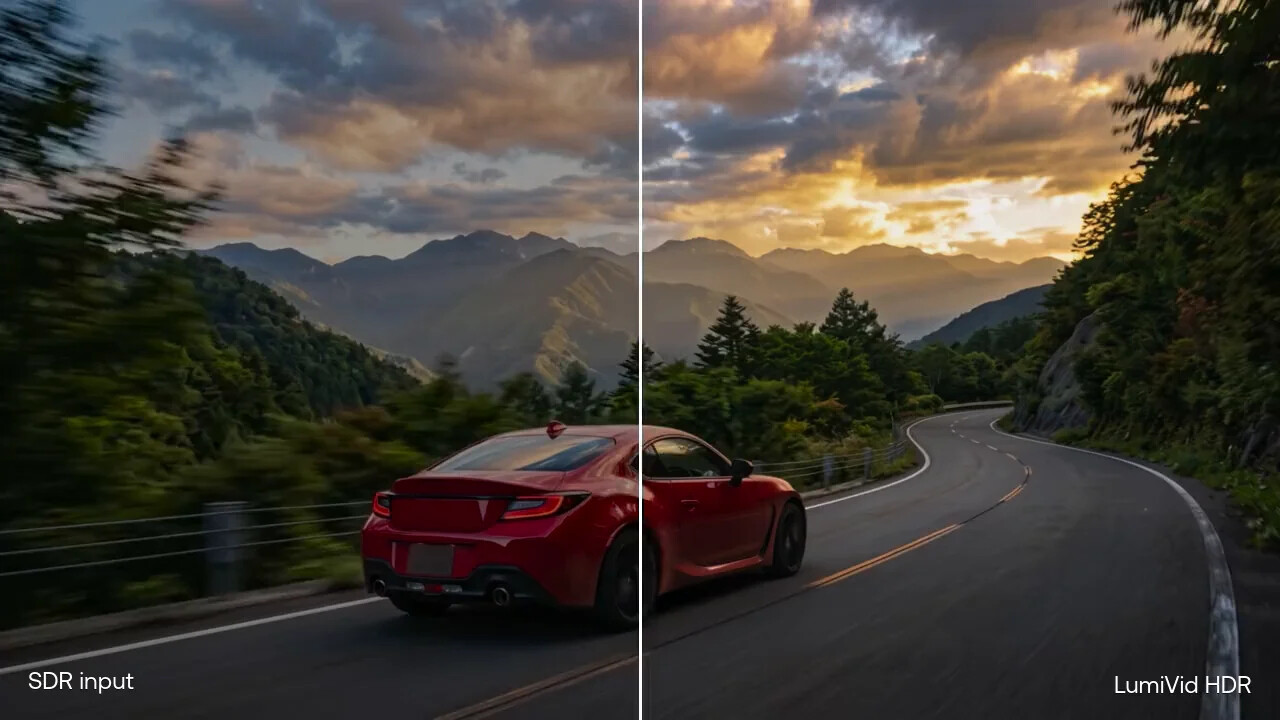
«Um pequeno adaptador aprende a preencher as luzes e as sombras que o vídeo de 8 bits corta».
É assim que a Lightricks descreve a essência da abordagem no seu blogue técnico.
Porque é que o vídeo generativo aguenta mal o grading
Os autores nomeiam o problema diretamente: os modelos de difusão de vídeo trabalham em SDR de 8 bits. No HDR guarda-se o brilho contínuo da cena, e o colorista pode baixar a exposição numa janela queimada ou levantar um canto escuro. No fotograma de 8 bits, no lugar da janela já há uma mancha branca e, nas sombras, uma queda para o preto. Ali não há nada para puxar. Por isso o clipe gerado monta-se mal com material HDR filmado e suporta mal uma correção séria.
Os autores dividem em dois grupos as formas existentes de adaptar modelos ao HDR. Umas alteram o espaço latente do codificador: para HDR treina-se uma nova representação, e isso é complexidade a mais e grandes exigências quanto aos dados. Outras apoiam-se em entradas auxiliares: máscaras de brilho, prompts de texto, imagens de referência externas. Segundo os investigadores, isso acrescenta trabalho manual, um prompt preciso é difícil de encontrar e o resultado é menos estável e divergente, muitas vezes, do material original. O LumiVid contenta-se com um único clipe SDR à entrada.
Como o logaritmo substitui um novo modelo
A observação chave do trabalho é esta: a codificação logarítmica comprime o HDR numa distribuição que coincide bem com aquela em que o modelo de vídeo já foi treinado. O modelo não tem de dominar um novo tipo de dados. Basta um treino adicional leve do adaptador, e o codificador mantém-se o mesmo. Segundo os dados dos autores, para o treino bastaram cerca de 300 pares sintéticos de clipes de 49 fotogramas cada, montados em cenas da Poly Haven.
A segunda parte do método diz respeito ao treino. Para que o modelo deduza por si os detalhes ausentes, os autores estragam os fotogramas SDR de entrada do mesmo modo que os estraga uma câmara: cortam o contraste, desfocam luzes e sombras, acrescentam artefactos de compressão MP4 e deslocam a exposição. Copiar píxeis o modelo não consegue, e restaura a gama dinâmica apoiando-se no que já sabe sobre o mundo. Na página do projeto está publicada uma comparação de três variantes: sem essa aumentação, apenas com desfoque e o modelo completo.
Ali mesmo mostra-se uma experiência de controlo, útil para compreender o método. Se passarmos o material apenas pelo descodificador, sem o próprio modelo de vídeo, a exposição pode ser levantada, mas os detalhes nas luzes não são restaurados, e não há estabilidade entre fotogramas. Daí decorre que é o modelo generativo que reconstrói a informação perdida.
O que se pode verificar por conta própria
Na página do projeto estão reunidos resultados SDR→HDR para vídeo e para fotogramas isolados. Um visualizador interativo permite deslocar a exposição até −3 EV, para verificar as luzes, e até +3 EV, para olhar as sombras. Ali o LumiVid é comparado com três métodos:
- Tedla et al. pela receita oficial: 17 fotogramas na resolução 704×1280; depois disso este método mantém o último fotograma enquanto o LumiVid continua;
- HDRTVNet++: processa os fotogramas um a um e depois estes são colados num vídeo;
- DiffHDR: pela receita oficial, com EXR lineares em Rec.709 à saída.
Para a apresentação, o resultado do LumiVid é convertido de EXR ACEScct para Rec.709 com uma subida de 2 EV e depois para BT.2020 HLG. O SDR original mantém-se em Rec.709. Além da comparação visual, os autores apresentam também uma medição: em material cinematográfico de câmaras ARRI, o LumiVid supera os melhores métodos existentes em 5,5 dB na métrica PU21-PSNR. A descrição completa do método está no artigo no arXiv. Os seus autores são a equipa da Lightricks, Mohamed Oumoumad da Gear Productions, e ainda Or Patashnik e Daniel Cohen-Or da Universidade de Tel Aviv.
A quem isto servirá e o que ainda não existe
A julgar pela descrição, o método dirige-se em primeiro lugar a coloristas e compositores que inserem planos gerados em material real. Atualmente, um plano desses comporta-se muitas vezes na montagem como estranho: as luzes fazem clipping, as sombras não se puxam. O EXR scene-linear à saída provavelmente permitirá fazer-lhe grading com as mesmas ferramentas que ao material filmado. Como à entrada se dá um clipe SDR comum, teoricamente a abordagem também é aplicável a material SDR já existente, mas os autores não analisam esse cenário em separado.
Nos produtos da Lightricks o terreno para isso já está preparado. Na documentação do LTX há uma secção sobre o trabalho com EXR e HDR: o modo Native HDR aceita OpenEXR scene-linear ou ACEScct, fotogramas e sequências, e devolve HDR com gestão de cor, para que o material siga para composição e finishing. Para as fontes SDR é mencionado ali um cenário separado, SDR to HDR, com os seus próprios modelos. Se é precisamente o LumiVid que lhe está associado, não é especificado nos materiais publicados.
Há também limitações. Nos materiais publicados não são indicados os requisitos de placa gráfica e o tempo de processamento, nem informações sobre se o código do próprio LumiVid será disponibilizado. Os detalhes nas luzes queimadas o modelo reconstrói a partir de representações aprendidas: no fotograma original esses dados não existem. Resulta um detalhe verosímil, mas inventado, e para o trabalho de VFX, onde importa a fidelidade factual do fotograma, vale a pena ter isso em conta.
Aceitarão os coloristas e os supervisores de VFX um detalhe inventado pelo modelo nas luzes, ou para o finishing continuará a ser demasiado arriscado?