
LightX2V lança uma versão do Qwen-Image-2.1 a que bastam 4 passos em vez de 40
A equipa da LightX2V publicou no Hugging Face o modelo Qwen-Image-2.1-Lightning-v2-RL. É uma versão acelerada do gerador Qwen-Image-2.1, que cria e edita imagens em 4 passos de remoção de ruído. Na comparação dos desenvolvedores, o modelo base precisa de 40. O modelo tem 7 mil milhões de parâmetros e cobre três tarefas: geração a partir de texto, edição a partir de uma única referência e composição de um enquadramento a partir de várias referências.
Um artista que experimenta variantes de composição ou faz dezenas de correções no mesmo enquadramento passa a ter dez vezes menos passos em cada iteração. Isto deverá reduzir o tempo de espera, embora os desenvolvedores não apresentem medições em segundos. Há duas limitações importantes: o modelo herdou a licença não comercial do Qwen-Image-2.1 base e os próprios desenvolvedores avisam que, em vários casos, os resultados terão de ser verificados manualmente.
O que a versão rápida consegue fazer
O modelo é construído sobre o Lightning v2, a versão destilada do Qwen-Image-2.1 feita pela LightX2V. No novo lançamento, foi treinada adicionalmente com aprendizagem por reforço, através da ferramenta própria da equipa, LightX2V RL. Os três modos funcionam com CFG = 1.0, valor definido no lançamento.
- Texto para imagem. Exemplo da ficha do modelo: um bule de cerâmica junto a uma taça de laranjas sobre uma mesa de madeira, luz suave da manhã a entrar pela janela, vidrado detalhado.
- Edição a partir de uma única referência. O modelo altera o detalhe escolhido e mantém o resto. No exemplo dos desenvolvedores, o casaco de uma personagem é repintado de verde-escuro, enquanto o prompt exige que o rosto, a pose e o ambiente permaneçam iguais.
- Geração a partir de várias referências. O modelo compõe um enquadramento a partir de fontes diferentes. No exemplo, a pessoa da primeira imagem veste o casaco da segunda; o prompt exige preservar o seu aspeto e o design da peça e define um fundo de estúdio simples. As referências devem ser fornecidas na mesma ordem em que são nomeadas no prompt.
Os exemplos da ficha estão pensados para uma saída de 1024 × 1024. Para outras proporções, ambos os lados do enquadramento devem ser múltiplos de 32.
Como é a comparação com 40 passos
A LightX2V publicou vários pares de imagens das suas execuções de verificação. Em cada par, os pesos originais do Qwen-Image-2.1 com 40 passos são confrontados com o novo modelo com 4 passos. As condições são iguais em ambas as versões: CFG = 1.0, os mesmos prompts expandidos completos, as mesmas referências e resolução de 1024 × 1024. Os prompts de origem estão abertos, por exemplo para a cena «Golfinho junto a uma costa em chamas».
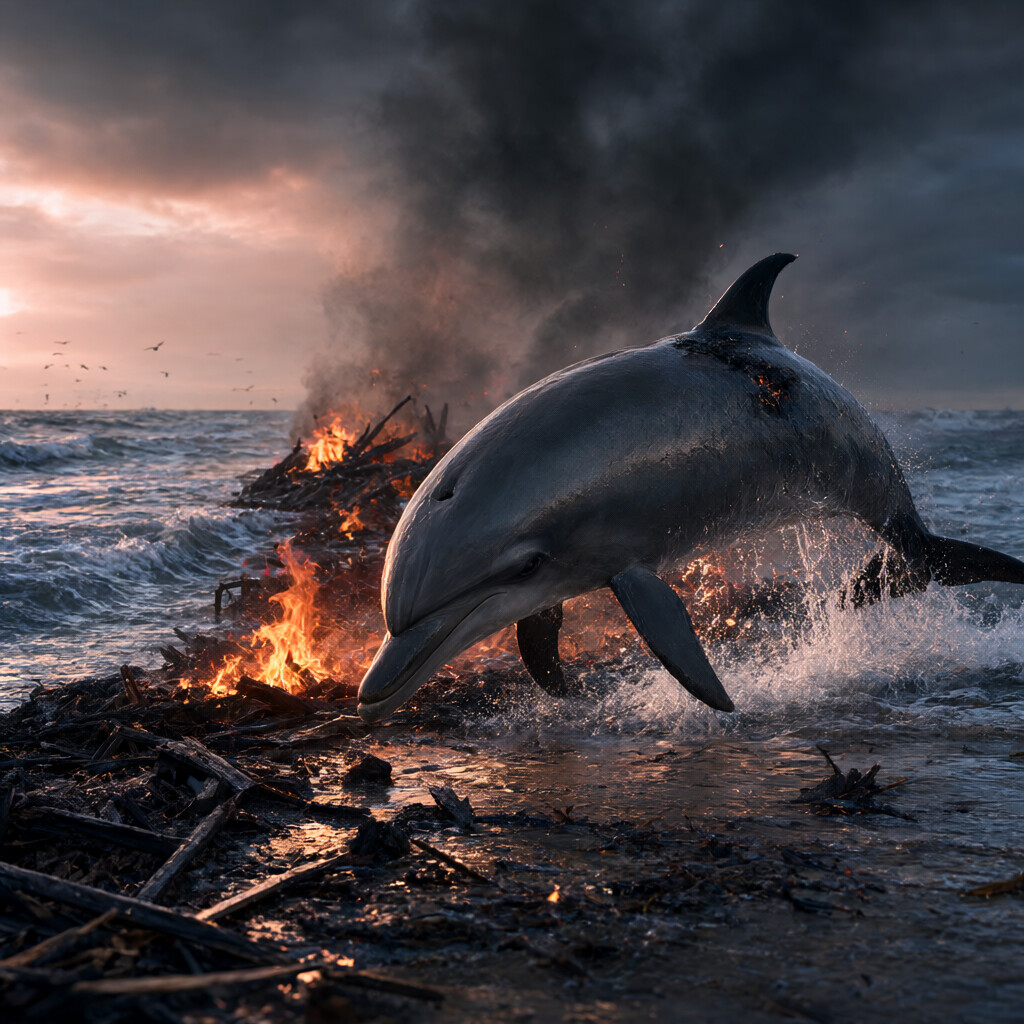
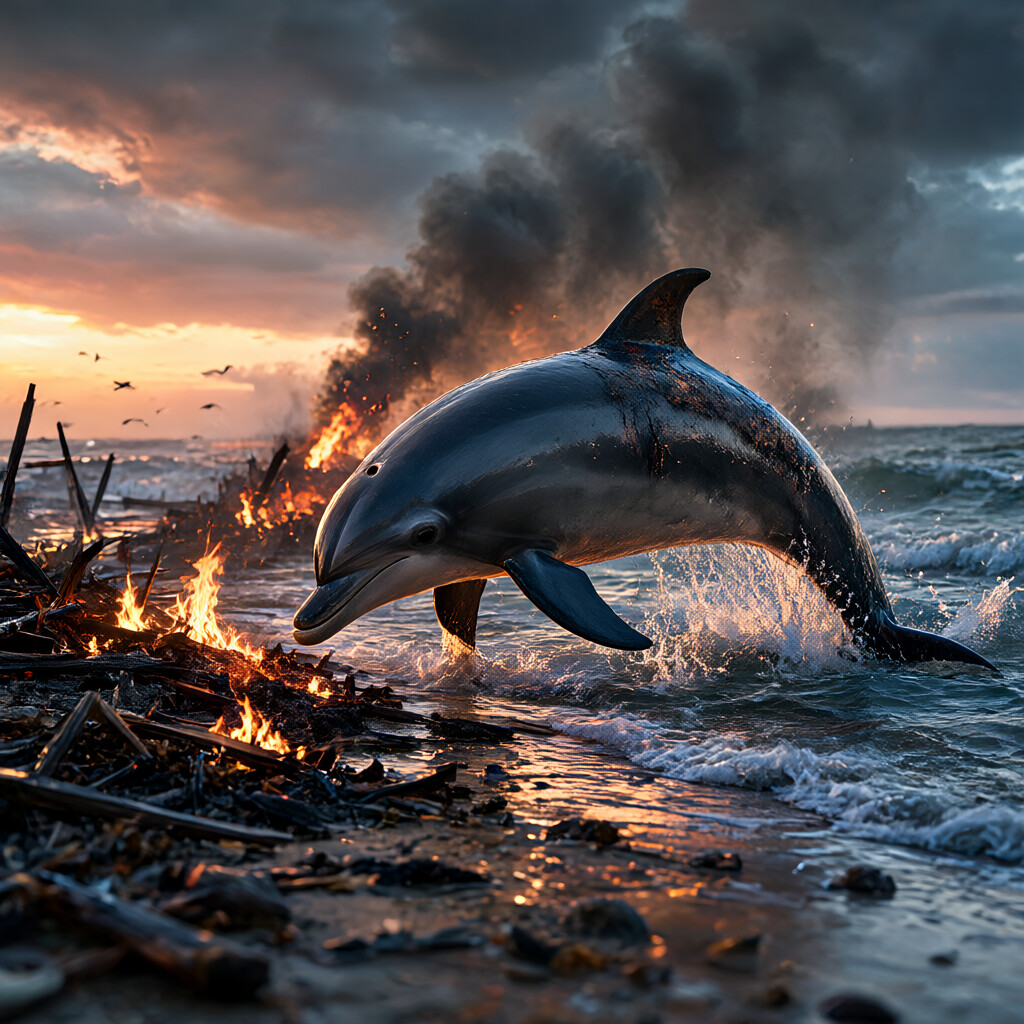
No modo de edição a partir de referência existe, por exemplo, a cena «Dragão a voar sobre jardins com cascatas»: a partir de uma única imagem de origem, ambos os modelos constroem um novo enquadramento de acordo com a descrição.
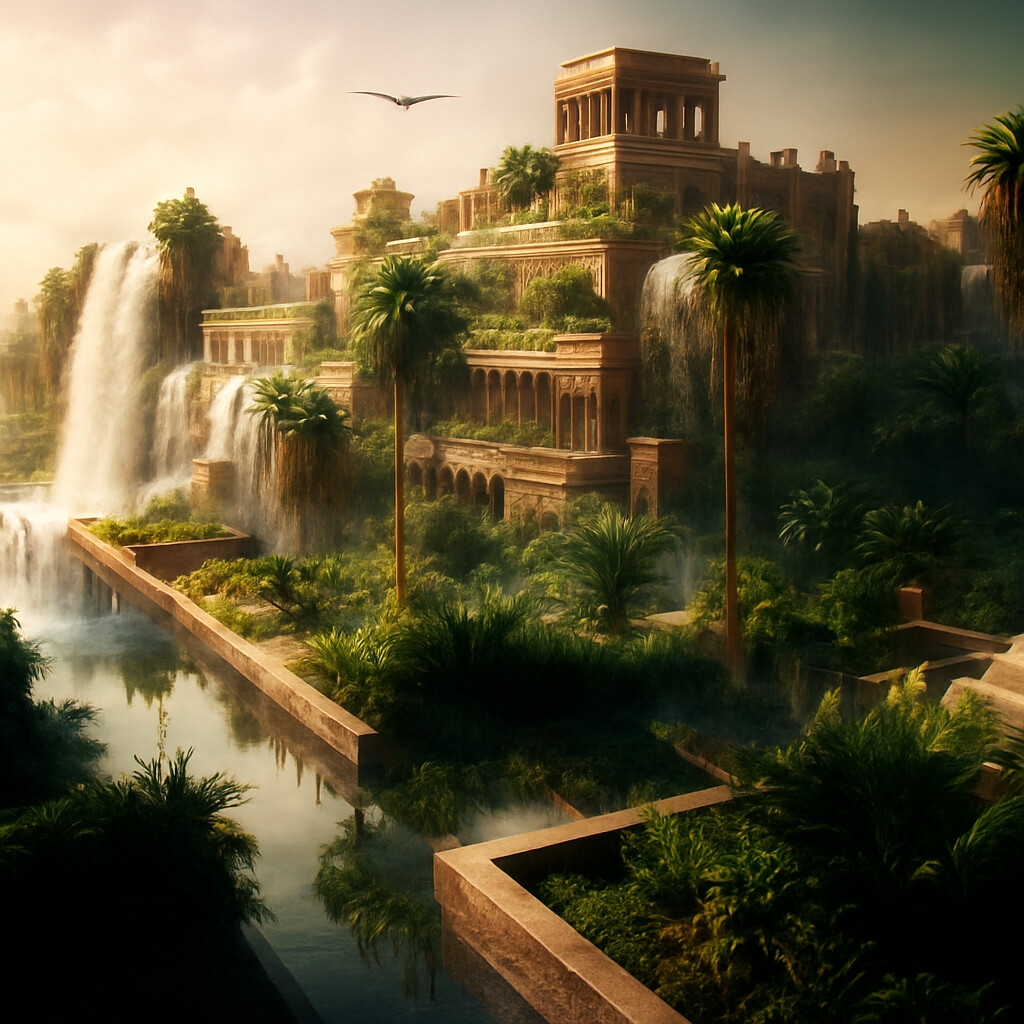
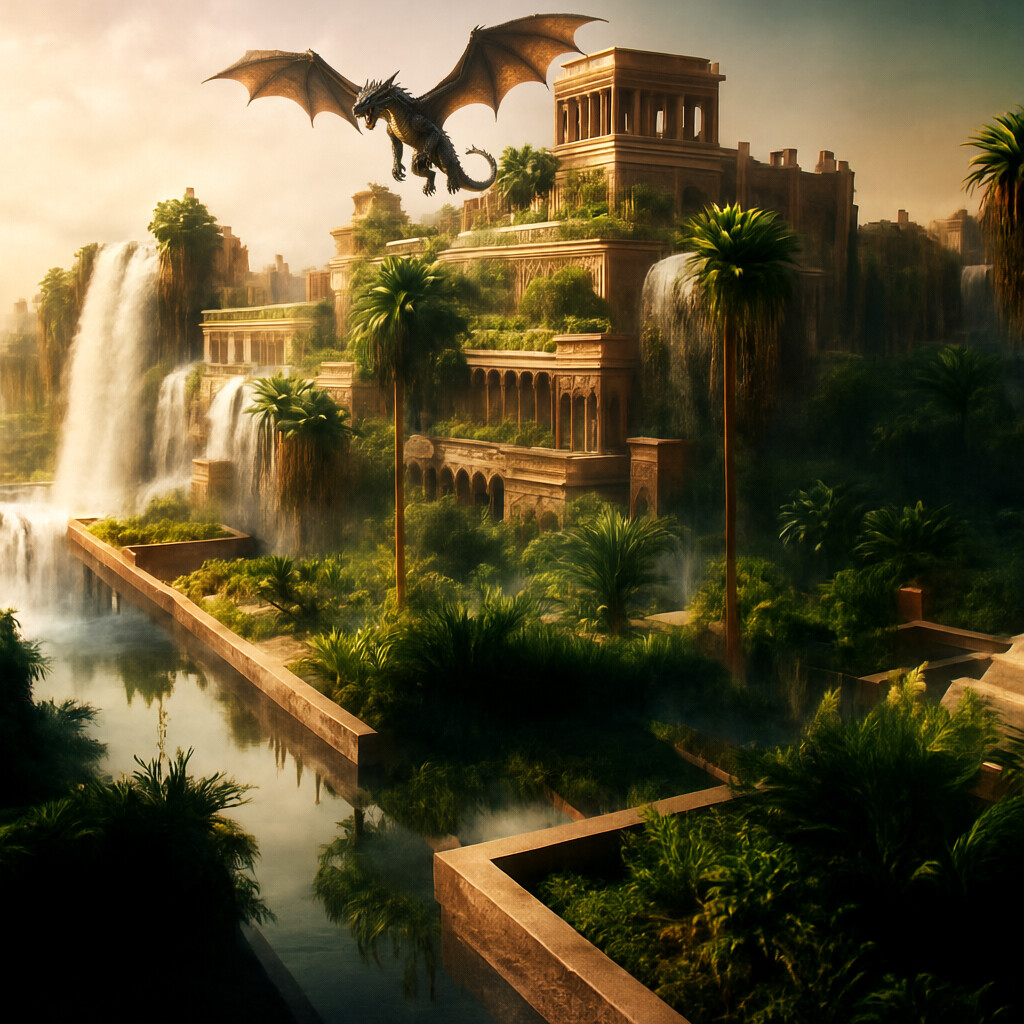
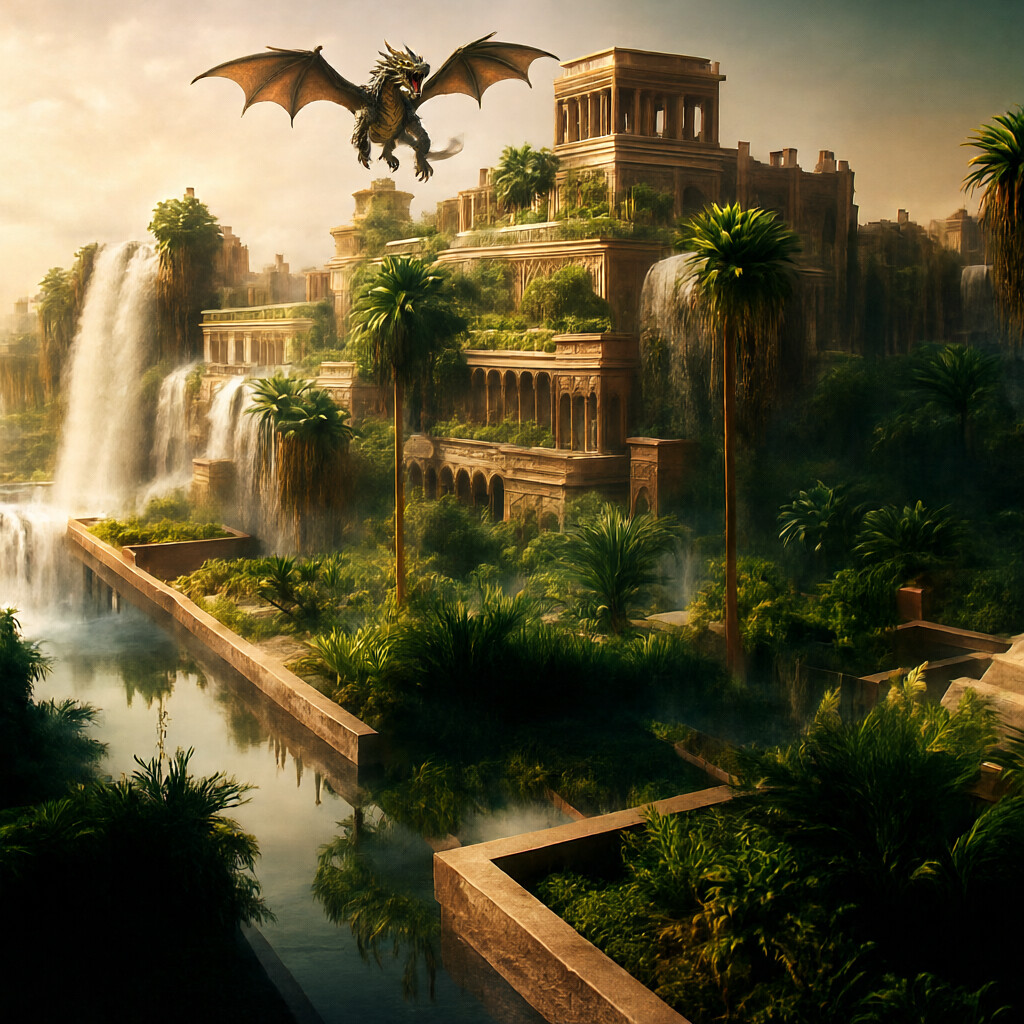
São exemplos selecionados, sem métricas numéricas de qualidade. Os desenvolvedores escrevem abertamente onde o modelo pode falhar:
«A qualidade da geração pode variar em função do prompt e da seed; texto pequeno, anatomia, contagem de objetos e a preservação exata das referências podem ainda exigir verificação».
É assim que está formulado na ficha do modelo da LightX2V. Em tarefas em que a precisão importa, por exemplo inscrições em embalagens, as mãos de uma personagem ou o reconhecimento de um produto concreto, a imagem final terá de ser verificada a olho.
O que é preciso para o executar
O lançamento consiste num conjunto completo de pesos da parte principal do gerador, o transformer, num único ficheiro em formato safetensors. Não é um adaptador LoRA e não é necessário acoplá-lo por cima do modelo base como um complemento. Os restantes componentes (o processador de dados de entrada, o codificador de texto e o VAE) são retirados do pipeline original do Qwen-Image-2.1 e descarregados do Hugging Face à medida do necessário.
- Os pesos estão guardados em FP32 e, para funcionar, podem ser carregados em BF16.
- É necessária uma versão recente da biblioteca Diffusers com suporte para Qwen-Image-2.1 e a biblioteca transformers não inferior à versão 5.17.0.
- Juntamente com os pesos existe um ficheiro separado com as definições de inferência: modelo base, quatro valores de nível de ruído para os passos, força do guidance e parâmetros do planificador. O Diffusers não lê este ficheiro por si próprio; é o exemplo de código da ficha que o faz.
- O escalonamento de passos tem de ser usado exatamente como está definido no lançamento, e igual para as três tarefas. Se se limitar a definir o número de passos como quatro, esse escalonamento não é reproduzido.
O último ponto diz respeito a todos os que vão integrar o modelo nas suas próprias ferramentas: o escalonamento terá de ser transposto do lançamento com exatidão.
Licença e a quem isto será útil
O modelo é derivado do Qwen-Image-2.1, pelo que se lhe aplica a Qwen Research License, incluindo as suas condições não comerciais. A licença permite a utilização apenas para fins de investigação e avaliação e, para aplicação comercial, exige uma licença separada do titular dos direitos. Para um estúdio ou um freelancer, isto significa que o modelo serve para experiências e testes internos, mas não para trabalhos de clientes.
No último mês o modelo foi descarregado 1449 vezes, e o Qwen-Image-2.1 base tem no Hugging Face 88 derivados retreinados. A novidade integra uma coleção da LightX2V com cinco posições dedicada ao Qwen-Image-2.1. Como trabalhos afins, os desenvolvedores remetem para o seu lançamento anterior Qwen-Image-2.1-Lightning e para o Qwen-Image-2.1-Turbo da equipa Qwen.
O que falta ainda no lançamento
O número de passos não equivale ao tempo de geração: a ficha do modelo não apresenta medições em segundos nem requisitos de memória de vídeo. Sobre o suporte do ComfyUI também não é dito nada, e o caminho oficial de execução passa por agora por código em Python e pelo Diffusers. Enquanto não surgirem nós para os ambientes nodais, o modelo irá provavelmente chegar antes de tudo aos artistas técnicos e aos desenvolvedores de pipelines, que o integrarão nas suas ferramentas por conta própria. Aos restantes, para trabalhar diretamente, faz sentido aguardar as integrações.
Sem comparações próprias, também não é claro como o novo modelo se posiciona face à versão Turbo da Qwen e ao primeiro Lightning. Os desenvolvedores mostram apenas a comparação com o modelo base a 40 passos, pelo que a escolha entre as variantes aceleradas terá de ser feita com as tarefas e os prompts de cada um.
Tornar-se-ão os 4 passos o novo padrão dos modelos abertos, ou a licença não comercial deixará a destilação da LightX2V como um brinquedo de nicho?